 KI
Mittagsüberblick vom 3. November 2026. Quellenstand: 09:50 Uhr MEZ. Drei Infrastruktur-Meldungen zum Mittag: Anthropic senkt die Latenz langer Agenten-Sessions mit Message Threads, OpenAI dokumentiert seine Aktivierungs-Sonden als Alignment-Schicht, und OpenAIs neues Git-Backend Pando trägt den Codex-getriebenen Monorepo-Verkehr.
Message Threads: Delta statt Vollhistorie
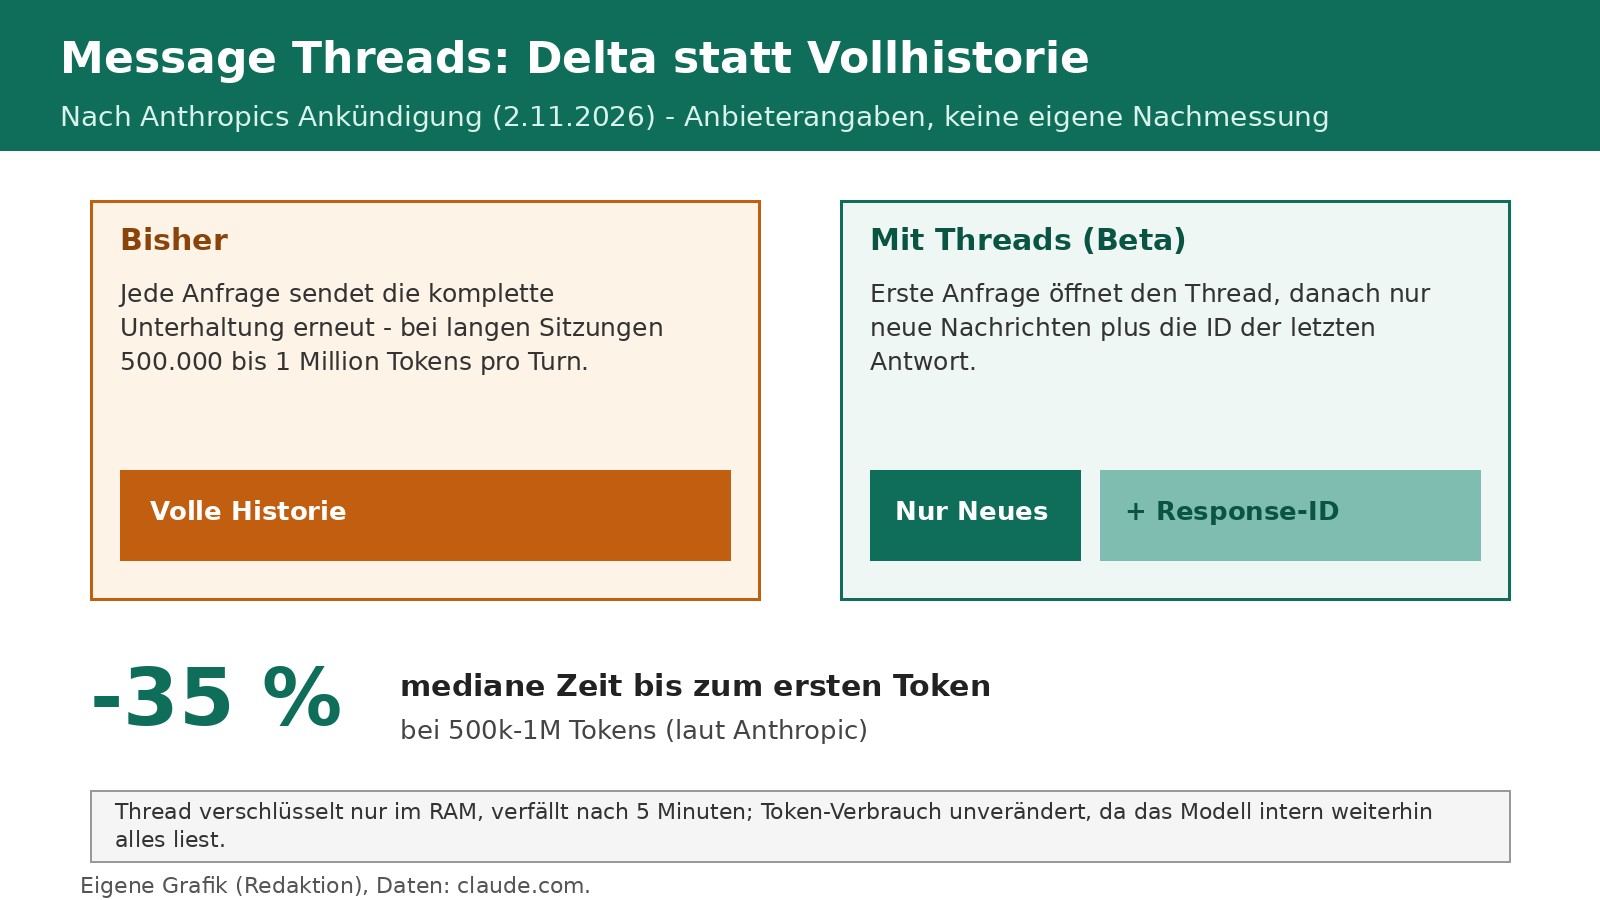
Anthropic hat Message Threads am 2. November in die öffentliche Beta gehoben (Messages API, Parameter thread). Die erste Anfrage enthält die volle Unterhaltung und eröffnet den Thread; jede Folgeanfrage sendet nur die neuen Nachrichten plus die ID der vorherigen Antwort. Laut Anthropic sinkt die mediane Time to First Token bei Anfragen mit 500.000 bis 1 Million Tokens um etwa 35 Prozent; für die meisten Claude-Code-Nutzer sei die Funktion bereits Standard. Der Thread wird verschlüsselt im Arbeitsspeicher gehalten, nicht auf Platte geschrieben und verfällt fünf Minuten nach der letzten Anfrage - danach startet ein neuer Thread mit Vollhistorie. Der Token-Verbrauch bleibt identisch, weil das Modell intern weiterhin die gesamte Unterhaltung liest. Verfügbar auf der nativen Claude-Plattform sowie auf AWS, Microsoft Foundry und Google Cloud (Anthropic-verwaltet), zu Standard-Tokenpreisen. Alle Zahlen sind Anbieterangaben ohne unabhängige Messung.
Aktivierungs-Sonden: OpenAIs White-Box-Monitore
OpenAI beschreibt in einem Alignment-Blogbeitrag (2. November) den Aufbau seiner Aktivierungs-Klassifikatoren: kleine Modelle (MLP plus QV-Attention mit exponentiellem gleitenden Mittel) lesen die Residual-Stream-Aktivierungen einer mittleren Schicht und geben pro Token einen Logit aus. Überschreitet er die Schwelle, stoppt das Streaming, Tool-Calls bleiben blockiert, und ein Reasoning-Modell fällt das Endurteil. Trainiert wird mit bis zu 1 Million synthetischen und de-identifizierten Unterhaltungen, Labels von Reasoning-Modellen, mindestens 32 Zufallsinitialisierungen pro Konfiguration. Seit GPT-5.6 laufen die Sonden auf allen Antworten der fähigsten Modelle.
OpenAI berichtet höhere Jailbreak-Robustheit als bei deutlich größeren Textklassifikatoren, gute Übertragbarkeit über Post-Training-Stufen und mitwachsende Sonderqualität bei fähigeren Modellen. Grenzen: nur trainierte Kategorien detektierbar, Neutraining pro Basismodell nötig, Übertragung über Pre-Training-Checkpoints eingeschränkt. Wichtig: Die Figuren stammen laut Beitrag aus internen Experimenten und sind nicht zwingend repräsentativ für die produktiv eingesetzten Klassifikatoren - sämtliche Werte sind Anbieterangaben ohne Fremdprüfung.
Pando: Git-Backend für Agenten-Tempo
Weil Codex die Entwicklung parallelisiert hat, fiel die Monorepo-Zuverlässigkeit bei OpenAI zeitweise unter 90 Prozent. Die Antwort ist Pando, ein Git-kompatibles Backend, das alle Entwicklung im Monorepo trägt: Schreibzugriffe werden pro Branch unabhängig koordiniert (Trade-off: ein Leser mehrerer Branches kann diese zu unterschiedlichen Zeitpunkten sehen), und Packfiles werden fetch-übergreifend wiederverwendet statt pro Client neu gebaut (Trade-off: Clients laden eventuell schon vorhandene Objekte erneut). Ergebnis laut OpenAI: mediane Push-Latenz um fast das Fünffache gesenkt, fast ein Petabyte Git-Daten pro Tag, Protokoll und Client unverändert. Client-Verbesserungen will OpenAI upstream ins Git-Projekt einbringen. Angaben aus dem OpenAI-Blog, keine unabhängige Prüfung.
Quellen
- Make long-running agents faster with message threads, Anthropic (Claude) (abgerufen 2026-11-03)
- Message threads (API-Dokumentation), Anthropic (Claude Platform Docs) (abgerufen 2026-11-03)
- Training activation classifiers for safety and alignment, OpenAI (Alignment-Blog) (abgerufen 2026-11-03)
- Scaling Git at OpenAI, OpenAI (abgerufen 2026-11-03)
- OpenAI Introduces Pando: A Git Backend That Cuts Median Push Latency ~80%, MarkTechPost (abgerufen 2026-11-03)