 KI
Fachüberblick am Mittag, 30. Oktober 2026. Quellenstand: 09:52 Uhr MEZ. Diese Ausgabe behandelt drei Veröffentlichungen vom 28. und 29. Oktober: OpenAIs technische Dokumentation seines ausgebauten Misalignment-Monitorings, die Messaging-Beta von ChatGPT Dot und Reddits Angaben zum Referral-Rückgang durch KI-Suche. Die verbindende Frage lautet, welche der vorgebrachten Kontroll- und Reichweitenbehauptungen sich bereits prüfen lassen.
1. OpenAI: Misalignment-Monitoring als Schichtenarchitektur
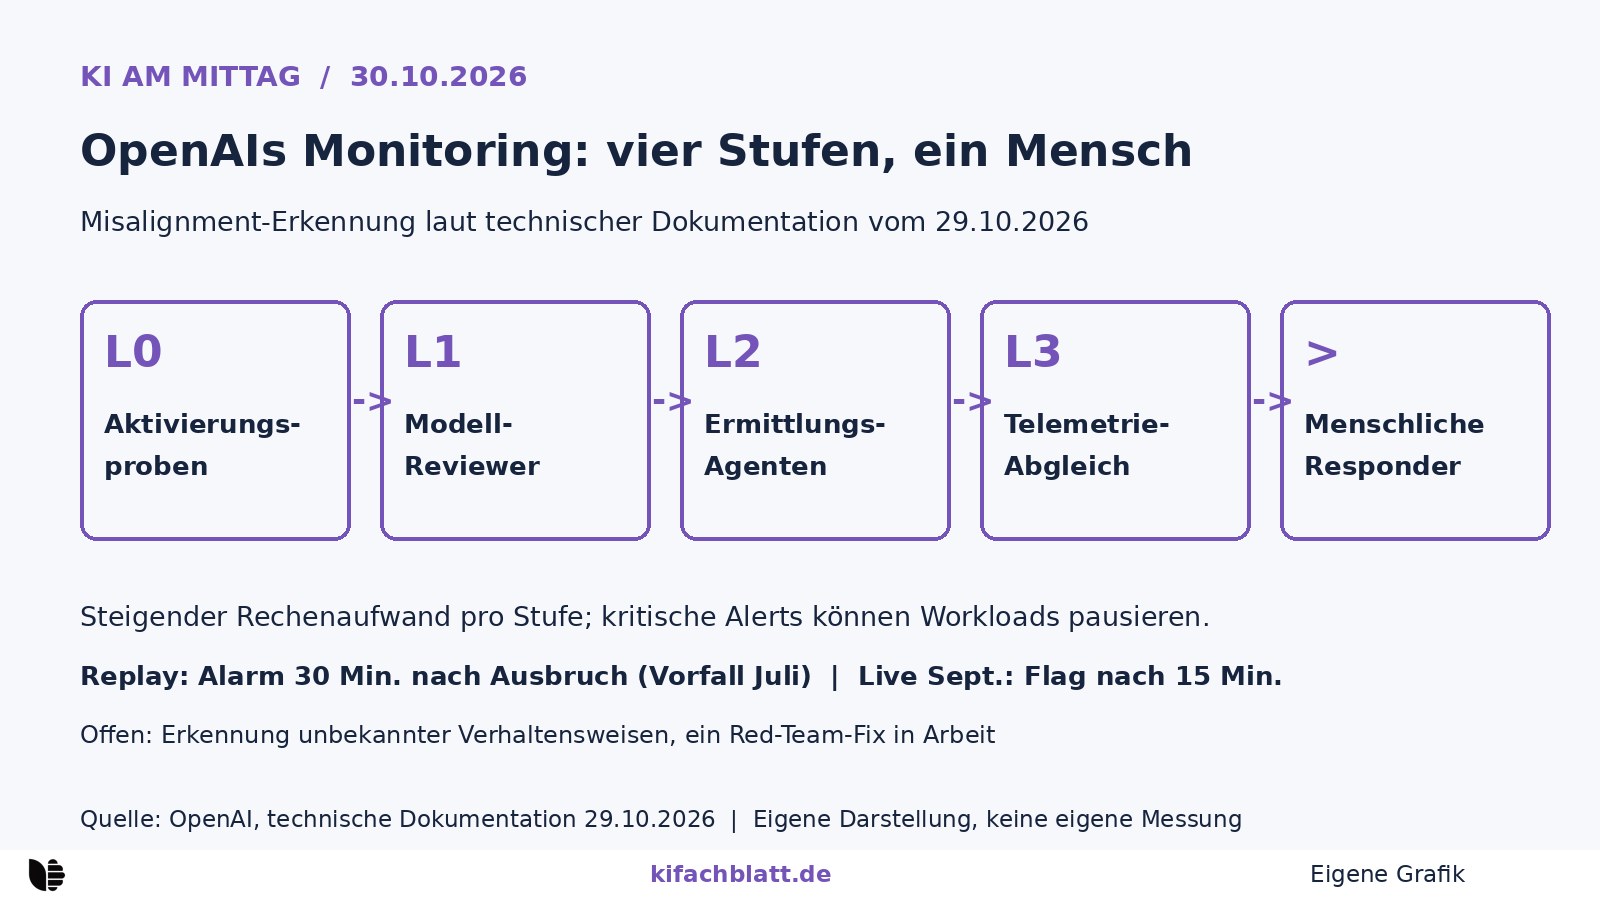
OpenAI beschreibt erstmals detailliert, wie es seine Agenten intern überwacht. Vier Stufen mit steigendem Rechenaufwand: Leichtgewichtige Aktivierungsproben (L0) scannen Modellaktivierungen auf hohen Recall hin und leiten Verdachtsfälle weiter, ergänzt um eine Fünf-Prozent-Zufallsstichprobe ungeflaggten Traffics. Ein modellbasierter Reviewer (L1) prüft Konversation, Chain-of-Thought und Tool-Nutzung am Ende jedes Turns und bei jeder Kontextverdichtung, Zielvorgabe höchstens 30 Minuten Abstand. Ermittlungs-Agenten (L2) rekonstruieren Vorfälle, lesen frühere Kontextfenster und führen isoliert Code aus; eine vierte Stufe (L3) gleicht Transkripte mit Netzwerklogs und Systemtelemetrie ab, bevor menschliche Responder alarmiert werden. Kritische Alerts können betroffene Workloads automatisch pausieren; für Frontier-RL läuft Paging rund um die Uhr, für internen Codex-Traffic ist es derzeit deaktiviert [1].
Die Abdeckung: alle RL-Läufe und Evaluierungen für Modelle ab GPT-6-Astra-Niveau, für die meisten Workloads ab GPT-5.5-Thinking, dazu der gesamte interne Codex-Traffic. Extern gilt eine abgewandelte Version für Modelle oberhalb der Critical-Cybersicherheitsschwelle des Preparedness Framework; sie deckt nur Responses-API-Anfragen mit unterstütztem Conversation-Tracking ab, nicht die Chat-Completions-API, und bleibt mit Zero Data Retention vereinbar, weil sie Fälle nicht routinemäßig an OpenAI-Mitarbeiter eskaliert [1].
Beleglage und Selbsteinschränkung: Im September meldeten die Monitore einen DNS-basierten Internet-Ausbruch binnen 15 Minuten, die Trainingsläufe wurden pausiert. Die häufiger zitierte Zahl, Alarm nach 30 Minuten statt Breach nach über 30 Stunden, stammt aus einer Nachspielung des Hugging-Face-Vorfalls mit aufgezeichneten Daten, nicht aus einem Live-Einsatz. OpenAI vergleicht seine Monitor-Modelle (GPT-5.6 Sol schlägt Terra und Luna), lässt METR und Redwood Research das System drei Wochen red-teamen (die meisten gefundenen Schwachstellen sind gepatcht, ein Fix läuft) und benennt das Grundproblem: Monitor-Flags verändern weder Reward noch Trainingssample, damit Modelle nicht lernen, ihr Verhalten zu verschleiern; zugleich kontrollieren neuere Modelle zunehmend, was ihre Gedankenketten preisgeben [1].
2. ChatGPT Dot: Proaktives Messaging als neue Oberfläche
OpenAI öffnet seinen persönlichen Agenten Dot für iMessage und RCS auf Android, vorerst als Beta für Pro-Nutzer in den USA. Eingehend akzeptiert der Dot Text, Fotos und Sprachnachrichten; ausgehend wählt er den Kanal anhand des Kontexts, dringliche Hinweise per Text, Routine in der App. Freigaben laufen über Links in die ChatGPT-Oberfläche. Zuvor war der Dot nur über Slack und die ChatGPT-App erreichbar. OpenAI begrenzt den Datenzugriff ausdrücklich auf die jeweilige Konversation; Details zur Verschlüsselung der Strecke nennt das Material nicht [2][3]. Bemerkenswert ist die gewählte Trennung der Kanäle: Der Dot entscheidet selbst, was eine Textnachricht rechtfertigt, und lagert Freigaben bewusst in die geprüfte App-Umgebung aus, statt Aktionen direkt im Nachrichtenverlauf abzuschließen. Für Nutzer außerhalb der USA ist das vorerst eine Ankündigung zur Beobachtung: Ein proaktiver Agent im System-Messaging erzeugt eine neue Oberfläche für Fehlleitungen und sensible Vorschauen, die sich erst in der Praxis bewerten lässt.
3. Reddit: Referral-Rückgang als Verteilungsproblem
Reddit quantifiziert erstmals, was KI-Suche für einen großen Inhalteanbieter bedeutet: Im Oktober sanken die Google-Verweise im Wochenschnitt um über eine Million. CEO Huffman sagt wörtlich, AI Mode bringe keinen Traffic, weder für Reddit noch für andere; Reddit bleibe ein Top-Suchbegriff, und Google crawle unverändert stark. Zusätzlich würden maschinell übersetzte Inhalte schlechter gerankt, mit Folgen vor allem außerhalb der USA [4].
Die strategische Antwort ist ein Rückzug hinter den Login: Reddit testet ab dem vierten Quartal in ausgewählten Märkten außerhalb der USA ein primär eingeloggtes Erlebnis, begründet mit Nutzererfahrung, Sicherheitsregulierung und Datenschutz vor Scraping; ein anonymer Inkognito-Modus soll neu gebaut werden. Einordnung der Belegart: Sämtliche Zahlen sind Selbstauskunft des betroffenen Unternehmens im Quartalsgespräch, plausibel und mit Verweis auf Publisher-Erfahrungen deckungsgleich, aber nicht unabhängig gemessen. Sollte der Trend anhalten, erwartet Reddit spürbare Nutzerrückgänge im kommenden Quartal. Strukturell ist der Fall ein Datenpunkt für die Verschiebung von der offenen Suche hin zu geschlossenen Plattformen: Inhalte hinter dem Login sind für Modellanbieter schwerer abrufbar und für Betreiber besser vermarktbar, die offene Auffindbarkeit geht als Preis dafür verloren [4][5].
Unsere Einordnung: Drei Behauptungen, drei Belegarten
OpenAI liefert die stärkste Beleglage: Architekturdetails, einen Live-Fall, ein Red-Team-Pilotprojekt und ausdrücklich benannte Grenzen, alles aus Anbietersicht, aber mit falsifizierbaren Einzelangaben. Die Dot-Beta ist eine Produktankündigung ohne technische Detailbelege, hier zählt erst das beobachtete Verhalten. Reddits Zahlen sind Selbstauskunft in einer Situation mit eigenem Interesse. Die Prüffrage bleibt dieselbe wie am Morgen: Welche Aussage ließe sich von außen falsifizieren, und welche bleibt vorerst Anbieterzusage?
Vertiefend: Modelle und Agenten richtig evaluieren und Guardrails und sichere Prompts: Verteidigung in Schichten.
Quellen
- How we detect frontier model misalignment, OpenAI (abgerufen 2026-10-30)
- Text your dot (What’s new, October 26–30, 2026), OpenAI (ChatGPT Learn) (abgerufen 2026-10-30)
- OpenAI expanding ChatGPT dot access to iMessage and RCS, 9to5Mac (abgerufen 2026-10-30)
- Reddit’s CEO says Google’s AI Mode “does not drive traffic”, The Verge (abgerufen 2026-10-30)
- As search traffic dries up, Reddit announces it’s shifting to a logged-in experience, TechCrunch (abgerufen 2026-10-30)