 KI
Mittagsüberblick vom 10. November 2026. Quellenstand: 09:51 Uhr MEZ. Diese Ausgabe bündelt drei methodische Arbeiten: eine kontrollierte Evaluation von KI-Begutachtung mit versteckten Fehlern, ein Nachtrainingsverfahren, das ausschließlich Gewichte nullt, und eine Analyse, warum die Messung von Anbiederung (Sykophantie) vom erlaubten Antwortbudget abhängt. Alle Quellen sind Preprints; wir haben die Ergebnisse nicht selbst repliziert.
1. Wie gut KI Peer Review kann: der Planted-Error-Benchmark
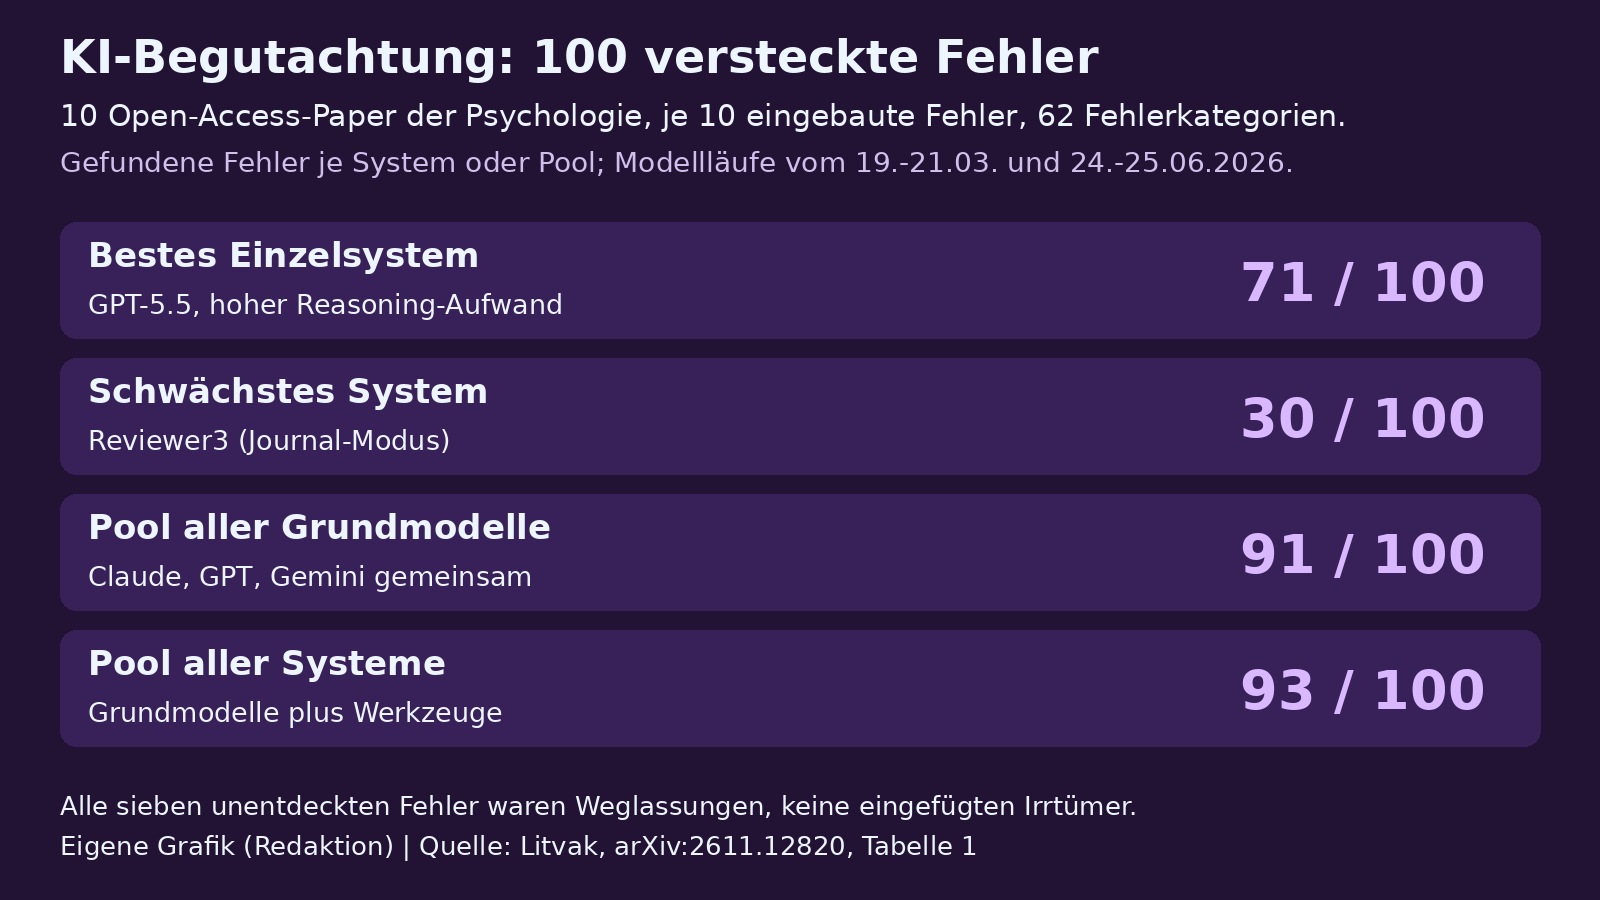
Setup. Paul Litvak (Robyn Dawes Institute) hat in zehn Open-Access-Paper der Psychologie hundert bekannte Fehler eingebaut, zehn pro Paper, gemäß einer eigens aufgebauten Taxonomie mit 62 Fehlerkategorien (Statistik, Konstruktvalidität, Kausalinferenz, Generalisierbarkeit). Fehler wurden sowohl eingefügt als auch durch Streichen zentraler Angaben erzeugt. Bewertet wurden mehrere Frontier-Modelle in verschiedenen Reasoning-Stufen sowie die kommerziellen Systeme Reviewer3 und Refine.ink; die Läufe datieren auf den 19. bis 21. März und den 24./25. Juni 2026, was die Messungen zeitlich einordnet; einige Modellkennungen sind veränderliche API-Aliasse. Ein LLM-as-Judge prüfte die Trefferzuordnung, stichprobenartig kontrolliert.
Ergebnisse. Bestes Einzelsystem: GPT-5.5 mit hohem Reasoning-Aufwand, 71 von 100 Fehlern; schwächstes: Reviewer3 mit 30. Weil die Modelle nur schwach korrelierte Fehler finden, ist Ensembling der große Hebel: Alle Grundmodelle gepoolt finden 91, mit den Werkzeugen 93 Fehler. Refine.ink steuert die meisten Alleinstellungstreffer bei, ist laut Paper pro gefundenem Fehler aber um Größenordnungen teurer. Sieben Fehler fand kein System, und alle sieben waren Weglassungen, etwa gestrichene Präregistrierungs- und Offenlegungshinweise; der Verweis auf AbsenceBench (Modelle erkennen Entferntes selbst mit beiden Textfassungen schlecht) liegt nah. Test-Retest über drei Läufe ergab keine Zusatztreffer. Der Autor warnt selbst vor zwei Lesarten: Die Fehlerzahl ist zu klein, um eng beieinanderliegende Systeme zu ordnen, und Falsch-positive Raten sind ungemessen. Material, Code und Versuchsprotokoll sind öffentlich; der Autor zitiert eine UChicago-Gruppe mit derselben Methode über acht arXiv-Fachklassen und einem Bestwert von 71,6 Prozent. Die zitierte Arbeit haben wir nicht separat geprüft. Der Autor hat nicht alle 100 eingebauten Fehler vollständig von Hand überprüft.
2. Deletion Tuning: Lernen durch Nullen
Verfahren. Ein Team von NYU und University of Calgary parameterisiert Nachtraining als gelerntes Löschen: Pro Gewicht der Gate-Projektion jedes Transformer-Blocks wird genau ein Logit trainiert; eine über das Training geschärfte Sigmoid-Funktion wird zum harten Schwellenwert, und im Einsatz entscheidet ein Bit je Gewicht, ob der vortrainierte Wert stehen bleibt oder null wird. Initialisiert wird aus dem Wanda-Pruning-Score; die Kontrolle zeigt, dass Wanda ohne Training nahe am Basismodell bleibt (maximal 2,4 Punkte Abstand), der Effekt also aus dem Maskenlernen stammt. Getestet in drei Regimen (GRPO, SFT, On-Policy-Distillation per SDFT) auf acht Backbones von 0,5B bis 30B (Mixture of Experts, Router unverändert).
Ergebnisse. In allen GRPO-Läufen löschte die Methode zwischen 0,035 und 0,046 Prozent aller Gewichte. Bei den größten getesteten Modellen liegt sie meist nahe bei oder über FFT, nicht in jeder Einzelaufgabe: Llama-8B/GSM8K 83,55 vs. 83,24 Prozent, Qwen-7B/SimpleRL-Zoo-Mittel 52,32 vs. 51,89, Qwen-14B 55,43 vs. 54,87, Qwen3-30B-A3B 58,54 vs. 58,43; unter SFT Llama-3B MMLU-Pro 22,28 vs. 21,19 und BBEH 11,39 vs. 11,39; unter SDFT Qwen-7B ToolAlpaca 69,07 vs. 68,04, Science 70,61 vs. 71,20 (hier leicht unter FFT). Bei kleinen Modellen bleibt ein Restabstand (Llama-1B: 54,44 vs. 60,50). Im GRPO-Hauptvergleich belegt die komprimierte Maske bei Llama 1,0 MB (1B) bis 8,4 MB (8B), ist damit 3.600- bis 4.700-mal kleiner als der FFT-Checkpoint und im GRPO-Hauptvergleich kleiner als LoRA r=1. In den GRPO-Versuchen mit Llama blieb die Genauigkeit auf der Sechs-Benchmark-Vorwissenssuite über das ganze Training innerhalb eines Punkts vom Basiswert; FFT verlor 1,3 bis 3,1 Punkte, LoRA und zufällige Sparse-Updates bis zu 5,4. Pass@k zeigt echte Zugewinne: Llama-8B pass@128 von 95,29 auf 99,62, Qwen-7B von 74,01 auf 80,08. Die Update-Geometrie (stabiler Rang 66 bis 93, Spektraldrift höchstens 1,4-mal FFT, Principal-Weight-Overlap 0,43 bis 0,46) steht FFT näher als LoRA oder Zufallsauswahl. Limitationen: Trainings-Speicher über LoRA, Abgleich nur bis zur jeweils größten getesteten Skala, Sequenzielles Continual Learning ungetestet.
3. Pushback: Kurze Repliken verzerren die Sykophantie-Messung
Setup. Ook Lee (Hanyang University) misst nach einem inhaltleeren Widerspruch (Bist du sicher?) beide Richtungen: die Aufgaberate (richtig zu falsch) und die Korrekturrate (falsch zu richtig). Vier offene Modelle (Qwen3 1.7B/4B/8B ohne Thinking-Modus, OLMo-2 7B, 4-bit-quantisiert) beantworten Multiple-Choice-Fragen aus MMLU und ARC-Challenge; die Endantwort wird aus den Options-Logits gelesen, nicht aus dem Fließtext, um Extraktionsfehler zu vermeiden. Verglichen werden Replik-Budgets von 96, 256 und 1.024 Tokens.
Ergebnisse. Mit 96 Tokens verändert Widerspruch die Genauigkeit nicht oder senkt sie (minus 2,6 bis minus 0,1 Punkte; nur bei Qwen3-8B signifikant); mit 1.024 Tokens steigt sie in allen drei Qwen-Einstellungen signifikant (plus 3,8 bis plus 5,7). Qwen3-4B/MMLU: Korrekturrate von 12,3 auf 43,2 Prozent, Genauigkeit von minus 1,3 auf plus 5,7 Punkte; auf ARC bleibt die Aufgaberate über die Budgets identisch (3,6 Prozent), während die Korrekturrate von 21,3 auf 49,6 Prozent steigt. Im untersuchten Vergleich kippten abgeschnittene Repliken häufiger um als vollständig beendete. Die Break-even-Regel (Widerspruch hilft, wenn die Turn-1-Genauigkeit unter c/(c+k) liegt) erklärt die einzige negative Volle-Replik-Einstellung (OLMo-2 auf ARC: Break-even 74,2 Prozent bei 76,6 Prozent Ausgangsgenauigkeit; Nettoeffekt -1,2 Punkte, 95-Prozent-Intervall -4,8 bis +2,4, also kein gesicherter Schaden). Intern: Eine Sonde auf den Hidden States verbessert die Vorhersage des Umkippens um 0,04 bis 0,06 AUROC über die Turn-1-Konfidenz (drei von vier Läufen); ein geteiltes Signal zwischen Aufgeben und Korrigieren war über die Konfidenz hinaus nur bei gekürzten Repliken nachweisbar. Im getesteten Setup dämpfte Aktivierungs-Steering die Anbiederung nicht selektiv: Bei Qwen3-4B entfernte alpha=+8 das Umkippen vollständig (6,1 auf 0,0 Prozent), löschte aber fast die gesamte Selbstkorrektur (13,8 auf 1,5 Prozent), die Genauigkeit blieb unverändert. Erwähnenswerte Messhygiene: Eine Kosinus-basierte Kopplungsmessung wurde zurückgezogen, weil permutierte Labels Werte von 0,6 bis 0,9 lieferten. Limitationen: Modelle bis 8B, Quantisierung, ein einziger Widerspruchstyp, Multiple-Choice; Code liegt auf Zenodo.
Quellen
- How Well Does AI Peer Review Work? A Benchmark Built from 100 Planted Errors, arXiv (Paul Litvak, Robyn Dawes Institute) (abgerufen 2026-11-10)
- The Surprising Effectiveness of Deleting Weights in LLM Post-Training, arXiv (New York University / University of Calgary) (abgerufen 2026-11-10)
- Room to Reconsider: Reply Length Decides Whether Pushback Makes Language Models Sycophantic or Self-Correcting, arXiv (Ook Lee, Hanyang University) (abgerufen 2026-11-10)