 KI
inclusionAI (Ant Research) hat am 13. November 2026 Duo v1 veröffentlicht: ein Weltmodell für Full-Duplex-Interaktion, das Nutzer fortlaufend per Audio, Video und Text wahrnimmt und in Echtzeit mit einer sprechenden Figur antwortet - inklusive spontaner Unterbrechungen in beide Richtungen [1][5]. Der technische Bericht trägt auf arXiv den 11. November; die Release-Ankündigung im GitHub-Repository ist auf den 13. November datiert. Zum Paket gehören vier Modell-Checkpoints und Streaming-Integrationen für vLLM-Omni und SGLang-Omni [1][2][5].
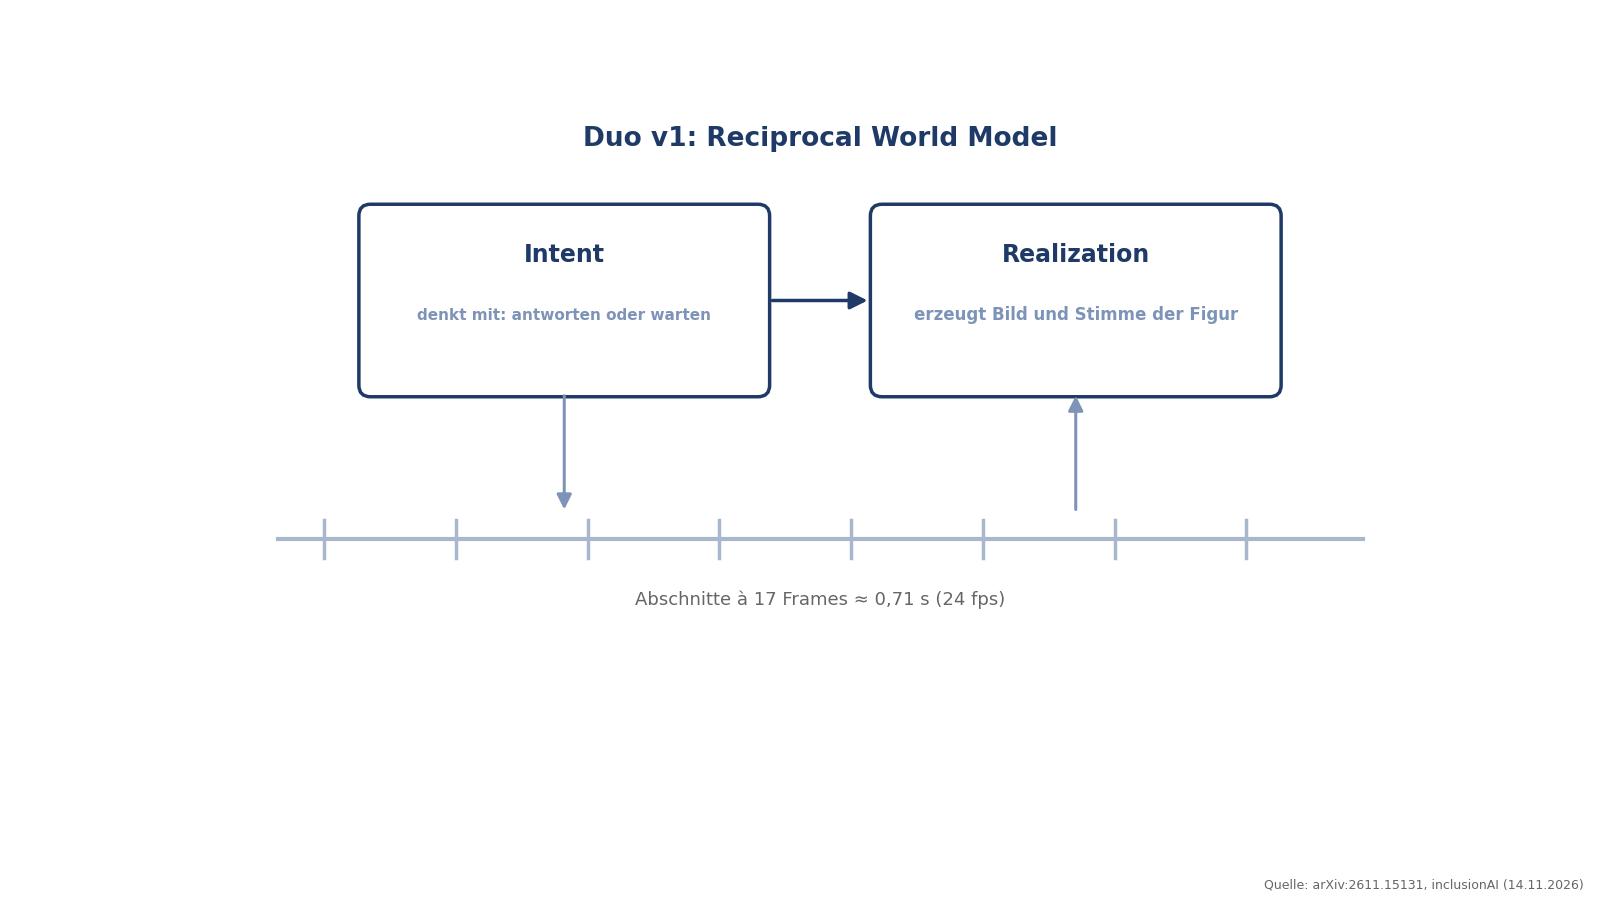
Intent und Realization auf einer Zeitachse
Das Konzept nennen die Autoren Reciprocal World Model: Intelligenz und physische Wirklichkeit seien gleichermaßen grundlegend für eine Welt [1]. Duo v1 setzt das modular um. Das Intent-Modul denkt autoregressiv über die laufende Interaktion nach und trifft Teilnahmeentscheidungen - antworten oder warten; das Realization-Modul erzeugt das kohärente audiovisuelle Verhalten der Figur [1]. Die Interaktion läuft in Abschnitten von 17 Videoframes, etwa 0,71 Sekunden bei 24 fps; chunk-spezifische Bedingungen und modulspezifische Aufmerksamkeitsmasken sichern die Kausalität, sodass keine Zukunft in Entscheidungen einfließt [1]. Gegen Verteilungsverschiebungen trainiert das Team mit dualer Rollout-Destillation: Das eingefrorene Intent-Modul erzeugt im Training die Züge selbst, und die Realization lernt auf diesen Rollouts einen Generator, der mit vier Sampling-Schritten auskommt [1][3]. Trainingsdaten sind nach Bericht skriptgesteuerte synthetische Videotelefonate und aufgezeichnete Gespräche [1].
Eckdaten
Vier Checkpoints: Duo-1.2-causal-base (Komplettpaket, Euler 50 Schritte, Flow Shift 1.0), Duo-1.0-causal-base, Duo-1.0-distill (Euler 4 Schritte, Flow Shift 5.0, Overlay auf der 1.0-Basis) und Duo-1.0-distill-quant (FP8) · Paketinhalt: Realization-Gewichte und Backbone, Intent-Modell und Adapter, Video- und Audio-Codecs, Spracherkenner, Forced Aligner · Format: PyTorch Distributed Checkpoint · Pipeline in v1: Nutzervideo und ASR-Text (Qwen3-ASR plus Forced Alignment) über Intent-Zustände zur Realization · Code unter Apache 2.0, Gewichte unter MiniMax-H3-Community-Lizenz [2][3][4][5].
Daten als Tabelle
| Sampling-Schritte | |
|---|---|
| Duo-1.2/1.0-causal-base | 50 |
| Duo-1.0-distill | 4 |
Herstellerangaben aus den Modellkarten: Standard-Sampler Euler, Basis mit Flow Shift 1.0, Destillation mit Flow Shift 5.0 [2][3].
Die Lizenz: offen, aber nicht überall
Die Gewichte wurden laut Modellkarte von MiniMax H3 initialisiert und anschließend vom Duo-Team weitertrainiert; deshalb gilt die MiniMax H3 Community License (von uns am 14.11.2026 vollständig gelesen) [2][4]. Deren Geltungsbereich ist ausdrücklich begrenzt: Ausgeschlossene Gebiete sind die Europäische Union, das Vereinigte Königreich, Südkorea und die USA (Abschnitt I.5); die Erlaubnis gilt nur innerhalb des übrigen Gebiets (Abschnitt II) [4]. Für Nutzer in der EU sind die Gewichte damit schlicht nicht lizenziert. Der Hersteller der Lizenz verweist Interessenten aus ausgeschlossenen Gebieten auf eine gesonderte Lizenzvereinbarung [4].
Weitere Bedingungen: Kommerzielle Produkte mit mehr als 20 Millionen US-Dollar Jahresumsatz brauchen eine vorherige schriftliche Genehmigung (Abschnitt IV.1); kommerzielle Produkte müssen MiniMax H3 prominent in der Oberfläche anzeigen (Abschnitt IV.2). Weitergabe erfordert den Lizenztext und eine NOTICE-Datei (Abschnitt III), und die Nutzungsbeschränkungen der Acceptable Use Policy sind an alle Empfänger weiterzureichen (Abschnitt V.2). Weil der Derivatbegriff auch destillierte und verhaltensähnliche Modelle erfasst (Abschnitt I.11), erben Abwandlungen die Lizenz einschließlich der Gebietsbeschränkung [4]. Das GitHub-Projekt nennt für seinen Code Apache 2.0. Deren Bedingungen und die gesonderten Lizenzen der Drittkomponenten bleiben zu beachten; der Code-Hinweis hebt die Gewichtelizenz nicht auf [5].
Für den Referenz-Offlinelauf nennt das GitHub-README Linux, Python ab 3.10 und zwei CUDA-GPUs: standardmäßig eine für Intent und Codecs, eine für Realization. Eine konkrete VRAM-Mindestzahl wird dort nicht angegeben. Diese Referenzaufteilung ist keine von uns getestete Hardware-Mindestanforderung für jede Integration [5].
Einordnung
Duo v1 ist ein bemerkenswerter Schritt von Weltmodellen, die Szenen simulieren, zu Weltmodellen, in denen jemand zuhört: Unterbrechungen, Warten und spontane Beiträge sind Teil des Modells, nicht des drumherum gebauten Systems [1]. Gleichzeitig ist es eine frühe Forschungsvorschau: In v1 steuert das Intent-Modul die Realization noch über Zustände aus Nutzervideo und ASR-Text; die direkte audiovisuelle Konditionierung kündigt das Team für Duo v2 an [5]. Für EU-Anwender bleibt der praktische Nutzen vorerst der Apache-2.0-Code und der arXiv-Bericht; die veröffentlichte Community-Lizenz erteilt für den Einsatz der Gewichte hier keine Erlaubnis, eine gesonderte Vereinbarung bleibt möglich [4]. Das Lizenzmuster erinnert an Baidus ERNIE-5.5-Basismodell, das ebenfalls Gebietsausschlüsse trug.
Methode
Quellenabgleich am 14. November 2026 gegen 07:15 MEZ: den arXiv-Vollbericht geladen und die einschlägigen Architektur-, Trainings- und Datenteile gelesen; Modellkarten von Duo-1.2-causal-base und Duo-1.0-distill, vollständige MiniMax-H3-Community-Lizenz und NOTICE im Gewichtsrepository sowie GitHub-README und Apache-2.0-Lizenztext geöffnet. Die 17-Frame-Abschnitte sind keine gemessene Antwortlatenz. Keine eigenen Gewichtetests.
Grenzen
Technikangaben stammen aus dem arXiv-Bericht und den Modellkarten des Herstellers; unabhängige Qualitäts- oder Latenzmessungen haben wir nicht geprüft. Das GitHub-README nennt Linux, Python ab 3.10 und zwei CUDA-GPUs für die Standard-Offlinedeployment-Aufteilung; eine konkrete VRAM-Mindestzahl nennt es nicht. Die Lizenzanalyse ist redaktionell, keine Rechtsberatung; für den gewerblichen Einsatz im ausgeschlossenen Gebiet verweist die Lizenz auf gesonderte Vereinbarungen mit dem Rechteinhaber.
Quellen
- Duo: A Reciprocal World Model for Full-Duplex Interaction (arXiv:2611.15131), arXiv / inclusionAI (abgerufen 2026-11-14) ↩1 ↩2 ↩3 ↩4 ↩5 ↩6
- inclusionAI/Duo-1.2-causal-base (Modellkarte und Plattform-API), Hugging Face (abgerufen 2026-11-14) ↩1 ↩2 ↩3 ↩4 ↩5 ↩6
- inclusionAI/Duo-1.0-distill (Modellkarte), Hugging Face (abgerufen 2026-11-14) ↩1 ↩2 ↩3 ↩4
- MiniMax H3 Community License Agreement (Lizenztext im Duo-Repository), MiniMax / inclusionAI (Hugging Face) (abgerufen 2026-11-14) ↩1 ↩2 ↩3 ↩4 ↩5 ↩6
- inclusionAI/Duo (Code, Apache 2.0), GitHub (abgerufen 2026-11-14) ↩1 ↩2 ↩3 ↩4 ↩5 ↩6