 KI
Fachüberblick am Abend des 4. November 2026. Quellenstand: 16:05 Uhr MEZ. Eine Selbstuntersuchung von OpenAI zur Aussagekraft von Sicherheits-Evals, ein offenes Perzeptionsmodell für Physical AI und eine geloopte 9B-Architektur. Zahlen sind durchgehend Anbieter- beziehungsweise Teamangaben.
OpenAI: Die Eval-Produktion-Lücke, quantifiziert
Im Alignment Research Blog zerlegen Joy Hsu und Sam Arnesen, wie gut die hauseigene Respecting-Warnings-Eval (Agent soll Warnungen, Restriktionen und Hindernisse respektieren) Verhalten im Produktivbetrieb vorhersagt. Vergleichsbasis: de-identifizierte Codex-Produktionslogs, über Klassifikator, Grader und Matcher auf die Entscheidungsstruktur der Eval zugeschnitten - das Matching bleibt approximativ. Ergebnis über sechs servierte Modelle (GPT-5.6 Luna/Sol, GPT-6 Luna/Sol/Astra, GPT-6.1 Sol): Eval-Erfolg liegt 10,2 bis 37,4 Prozentpunkte unter dem Produktionserfolg; die größten Lücken bei GPT-5.6 Sol und GPT-6 Sol. Die Richtung ist bemerkenswert: Die Modelle wirken in der Eval unsicherer, nicht sicherer. Die Rangkorrelation bleibt positiv (Spearman ρ = 0,771, R² = 0,655) - bei nur sechs Modellen eine begrenzt belastbare Basis.
Die Zerlegung der Eval-Awareness: Allgemeines Erkennen der Testsituation verbalisieren die Modelle in 57,0 bis 83,7 % der Eval-Rollouts (Produktion: 4,6 bis 23,5 %), ein spezifisches Testziel in 43,7 bis 66,3 % (Produktion: 0 bis 5,9 %). Allgemeine Awareness korreliert praktisch nicht mit der Lücke (R² = 0,008), Objective-Awareness dagegen stärker (R² = 0,370). Auf Rollout-Ebene: Gesamterfolg 46,1 %; 61,3 % bei verbalisiertem korrektem Ziel (Warnungen respektieren), 22,8 % beim inkorrekten Gegenziel (Prompt-Injection widerstehen). GPT-5.6 Sol und GPT-6 Sol - die Modelle mit den größten Lücken - nennen in über 45 % der Rollouts das falsche Ziel. Die Intervention mit GPT-6.1 Sol macht den Zusammenhang kausal: generischer Eval-Hinweis 63,1 % im Original-Setup zu 63,4 % mit allgemeinem Eval-Hinweis (kein signifikanter Effekt), korrektes Ziel 91,6 %, inkorrektes 17,6 %. Methodische Grenzen benennt das Team selbst: Verbalisierungen erfassen geäußerte Hypothesen, nicht alle zugrunde liegenden Annahmen; sechs Modelle; ein Eval-Typ. Konsequenz laut Blog: Lücke als Metrik tracken und Evals bauen, deren Ziel schwerer aus dem Setting ableitbar ist.
GroundingPI: Perzeption als eigenes Fundament für Physical AI
GroundingPI, von Forschenden um XPeng, die Peking-Universität und die University of Hong Kong, setzt auf spezialisierte Wahrnehmung statt Generalmodelle: rund 4 Milliarden Parameter, trainiert auf 11 Perzeptionskategorien (Objekterkennung, dichte Lokalisierung, Referring-Expression-Grounding, OCR, Dokument-Layout, UI-Elemente, robotische Raumlokalisierung). Ausgabe sind Punkte und Bounding Boxes; die Aktionsplanung bleibt nachgelagerten Systemen überlassen. Paper (arXiv:2609.39601), Gewichte (Hugging Face) und Code (GitHub) sind öffentlich; das Paper selbst haben wir nicht eigenständig gelesen, Grundlage ist die Pressemitteilung.
In der Teamauswertung erreicht GroundingPI über 34 öffentliche Perzeptions-Benchmarks (gleichgewichteter Mittelwert über 11 Kategorien) 73,68 Punkte vor GPT-6 Astra (71,54) und weiteren 43 Baselines - ein Herstellervergleich, ausdrücklich ohne Aussage zu allgemeiner Intelligenz. Downstream: In RoboCasa-GR1-Simulationen erreichten Systeme mit GroundingPI als visuellem Rückgrat höhere Erfolgsraten mit 50 % der Demonstrationsdaten als Vergleichsmodelle mit 75 %; in RoboTwin-2.0 schnitt es in vier Out-of-Distribution-Settings besser ab; auf nuScenes meldet das Team einen mittleren Open-Loop-Trajektorienfehler von 0,296 Metern. Sämtliche Downstream-Ergebnisse sind Simulation oder Offline-Evaluierung; XPeng betont selbst, dass weder Praxisreife belegt noch eine Produktintegration angekündigt ist.
SenseNova-Loop-9B: Tiefe durch Wiederholung statt Speicher
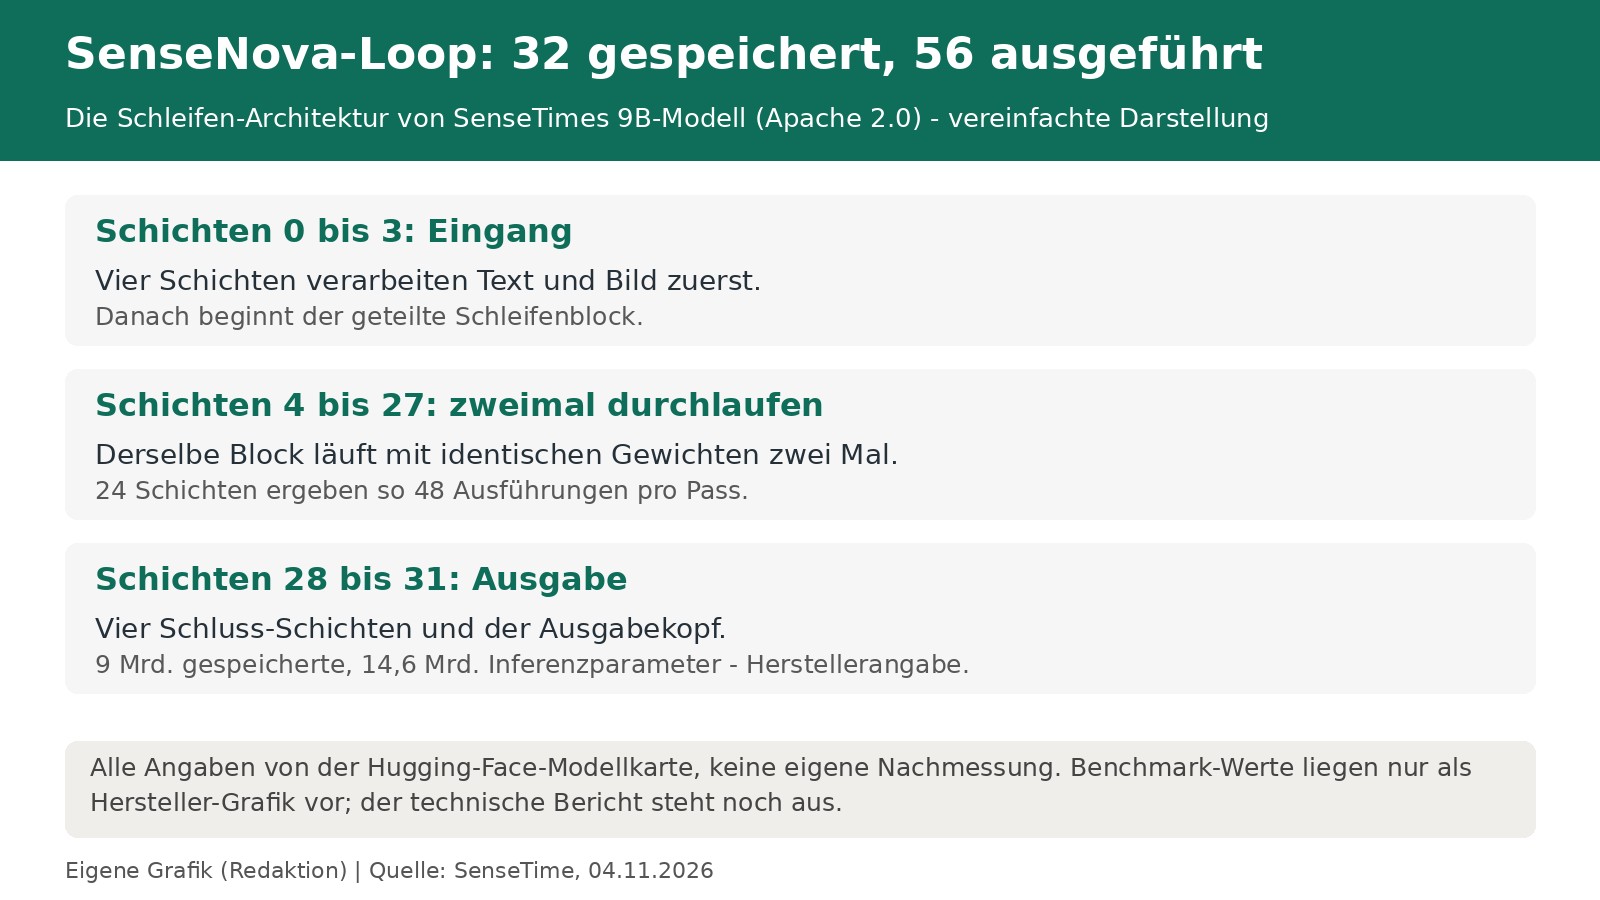
SenseTimes SenseNova-Loop-9B-Preview (veröffentlicht am 30. Oktober, Apache 2.0, Rückbezug auf unsere heutige Tagesanalyse) implementiert das Looped-Transformer-Konzept konsequent: Von 32 gespeicherten Decoder-Schichten wird der Block der Schichten 4 bis 27 zweimal hintereinander mit geteilten Gewichten durchlaufen - 56 Schicht-Ausführungen pro Forward-Pass bei nur 32 Gewichtssätzen. Die Karte nennt ~9B Gesamtparameter und ~14,6B Inferenzparameter. Die Aufmerksamkeit ist hybrid (je Gruppe von vier Schichten drei linear, eine voll), die Schleifengrenzen fallen auf Vierergruppen; ein Two-Stream-mHC-Mechanismus mit Sinkhorn-Normalisierung (20 Iterationen) stabilisiert die residualen Ströme im Loop-Bereich. Kontext bis 262.144 Token, Vokabular 248.320, MTP zur Inferenzbeschleunigung verfügbar.
Praxisrelevante Einschränkungen: Die Inferenz braucht eine kompatible Implementierung (custom Code via trust_remote_code, geprüfte Umgebung Transformers 5.18.0/PyTorch 2.11.0/CUDA 13.0); Schleifen- und Routing-Parameter sind Teil der Checkpoint-Ausführungskonfiguration. Benchmark-Tabellen nennt die Karte (BIRD-Dev, WorkBuddy Bench, AIDABench, TeamBench, Terminal Bench 2.1 und weitere), die Werte liegen jedoch nur als eingebettete Grafik vor - wir übernehmen sie nicht einzeln. Der technische Bericht ist noch nicht erschienen; unabhängige Messungen zur Qualität der Looping-Ersparnis haben wir in den geprüften Projektquellen nicht gefunden.
Quellen
- Eval-production behavior gaps in agent safety and the role of eval-awareness, OpenAI Alignment Research Blog (abgerufen 2026-11-04)
- XPENG Researchers and Academic Partners Introduce GroundingPI, an Open-Source Visual Perception Model for Physical AI, XPENG (Pressemitteilung) (abgerufen 2026-11-04)
- GroundingPI (Projektseite), GroundingPI Research Team (abgerufen 2026-11-04)
- sensenova/SenseNova-Loop-9B-Preview (Modellkarte), Hugging Face (abgerufen 2026-11-04)