 KI
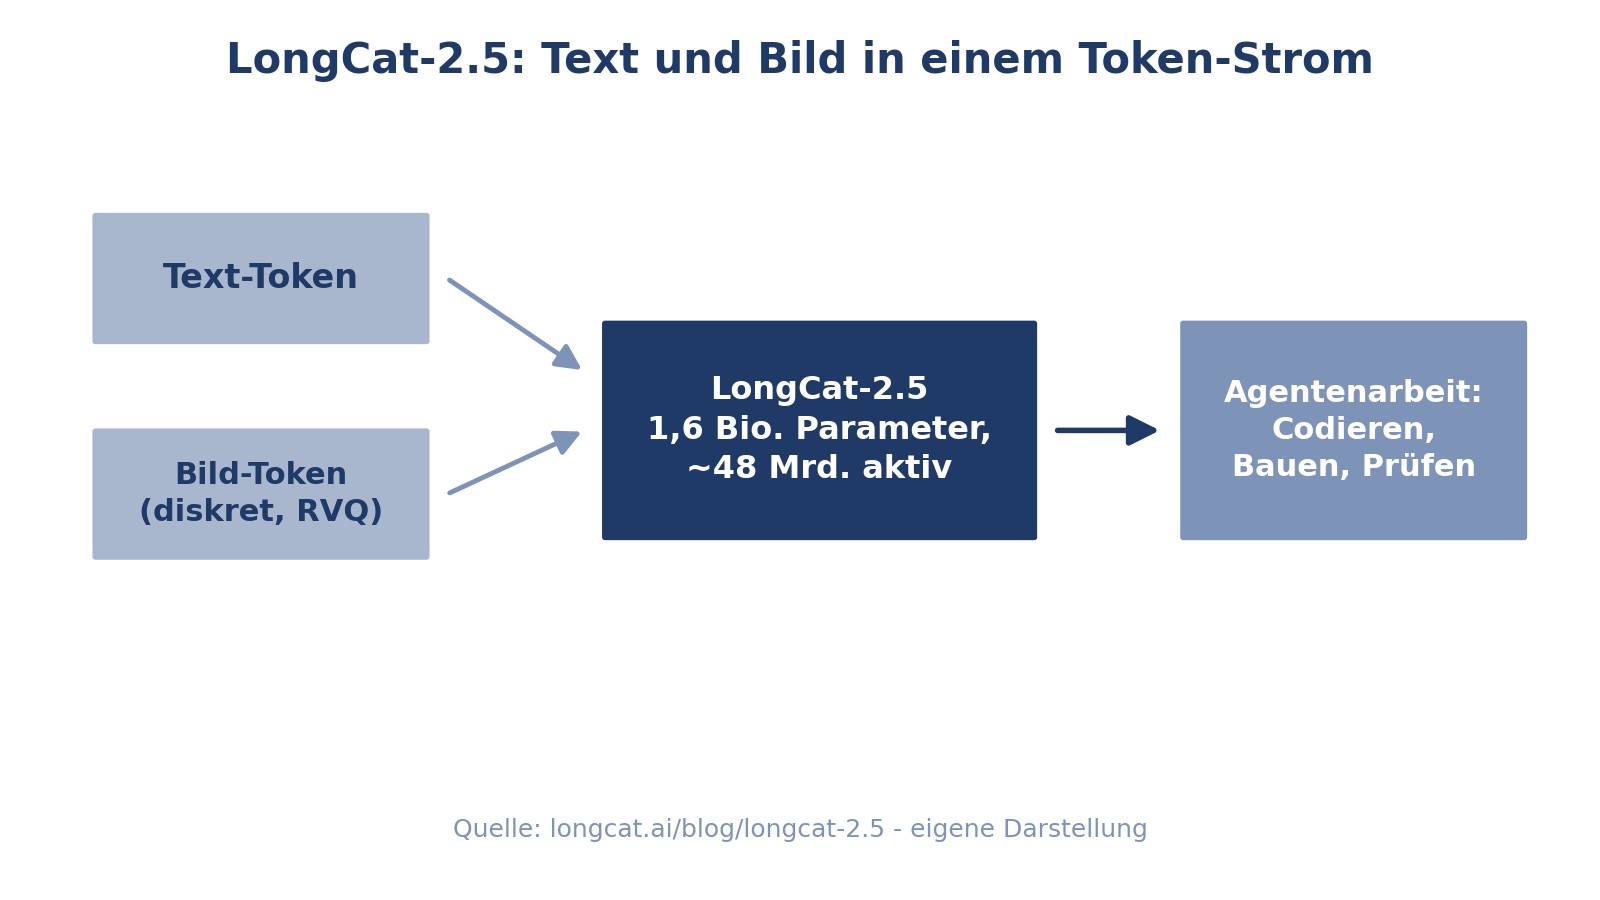
Meituan hat LongCat-2.5 vorgestellt, sein Modell für lange agentische Aufgaben: 1,6 Billionen Parameter gesamt, rund 48 Milliarden aktiv pro Token. Der Blog-Beitrag trägt das Datum 1. November; über das AI-Gateway von Vercel und die LongCat-Plattform ist das Modell seit dem 2. November abrufbar. Der Schwerpunkt liegt auf agentischem Programmieren - vom Planen über das Umsetzen bis zum Prüfen kompletter Projekte [1][2].
Die Eckdaten
| Eigenschaft | Wert |
|---|---|
| Architektur | Mixture-of-Experts, 1,6 Bio. Parameter gesamt, ca. 48 Mrd. aktiv pro Token |
| Multimodalität | Visuelle Signale als mehrstufige diskrete Tokens (Residuen-Vektorquantisierung über nativ aufgelöste Merkmale), verarbeitet im selben Backbone wie Text |
| Kontext | 1 Mio. Tokens (laut Vercel AI Gateway) |
| Training | Langsequenz-Midtraining und -SFT; groß angelegtes asynchrones agentisches RL; Multi-Teacher-Distillation (MOPD) |
| Inferenz | W4A4-Quantisierung auf inländischen Beschleunigern; laut Online-Stresstest +43,3 Prozent Prefill- und +42,77 Prozent Decode-Durchsatz gegenüber W8A8 |
| Zugang | LongCat-API (longcat.chat) und Vercel AI Gateway (Modellname meituan/longcat-2.5), Text- und Bildeingaben |
| Gewichte / Lizenz | Keine Angabe; das Lizenzfeld des unabhängigen Trackers bleibt leer [3] |
Die gemeldeten Messwerte
Meituan meldet für LongCat-2.5 unter anderem 88,4 Prozent auf Terminal Bench v2.1 (Claude-Code-Harness, 512K Kontext, Mittel aus drei Läufen; LongCat-2.0 lag bei 70,8), 64,6 auf DeepSWE v1.1 (9,7), 91,9 auf BrowseComp (79,9) und 63,1 auf HLE mit Werkzeugen (37,5) [1]. Die Tabelle kennzeichnet Fremdwerte sauber: Sternchen markiert Werte aus öffentlichen Berichten oder offiziellen Leaderboards, alle übrigen Fremdmessungen sind selbst gelaufen und laut Hersteller nur indikativ. Wir geben die Vergleichswerte anderer Modelle aus dieser Herstellertabelle nicht als deren eigene Werte wieder.
Daten als Tabelle
| Gemeldeter Wert in % | |
|---|---|
| Terminal Bench v2.1 | 88,4 |
| BrowseComp | 91,9 |
| MCP Atlas | 83,1 |
| DeepSWE v1.1 | 64,6 |
| HLE mit Werkzeugen | 63,1 |
Herstellerangaben aus dem LongCat-Blog (Einstellung enable_thinking=on, Temperatur 1,0), nicht unabhängig verifiziert [1]. Je Benchmark eigene Aufgaben und Harnesses - die Werte sind nicht testübergreifend vergleichbar.
Nativ multimodal statt angedockt
Anders als Modelle mit angeschlossenem Bild-Encoder bildet LongCat-2.5 visuelle Signale als mehrstufige diskrete Tokens ab: Eine Residuen-Vektorquantisierung zerlegt nativ aufgelöste Bildmerkmale in Token-Sequenzen, die das Backbone genauso verarbeitet wie Text. Weil der Tokenizer feststeht, lassen sich Bild-Token offline vorberechnen und zwischenspeichern - das vereinfacht laut Meituan das Packen langer Sequenzen und die Lastverteilung im Training. In t-SNE-Bildern eines kleineren Testmodells (etwa 3 Milliarden aktive Parameter) vermischen sich visuelle und textuelle Einbettungen im selben semantischen Raum - ein früher Beleg, kein Ergebnis am großen Modell [1].
Wie trainiert wurde
Für das agentische RL baut eine Pipeline aus echten GitHub-Pull-Requests automatisch Aufgaben, interaktive Umgebungen und verifizierbare Tests (Fail-to-Pass und Pass-to-Pass); Live-Erfolgsquoten steuern das Nachschärfen der Testfälle. Gegen Reward-Hacking werden Netzwerkzugang und Git-Historie in den Umgebungen entfernt und ein LLM-Prüfer auditet Trajektorien auf Tricks. Asynchrone Teil-Rollouts kürzen veraltete Gradientenbeiträge, und eine numerische Gleichschaltung von Training und Inferenz soll Kernel-Unterschiede ausschließen. Spezialfähigkeiten kommen per Multi-Teacher-Distillation aus den Expertengruppen von LongCat-2.0 [1].
Einordnung
LongCat-2.5 ist ein API-Release, kein Gewichte-Release: Wer das Modell will, geht über longcat.chat oder Vercels AI Gateway mit 1-Million-Token-Kontext; zu Gewichten und Lizenz schweigt der Hersteller, und der unabhängige Tracker lässt das Feld leer [1][2][3]. Auffällig ist die Infrastrukturseite: Training und W4A4-Inferenz laufen auf inländischen Beschleunigern - für Meituan ein Kosten- und Unabhängigkeitsthema. Alle Zahlen stammen aus einem einzigen Herstellerbeitrag; sie sind plausibel dokumentiert (Harness-Versionen, Laufanzahlen, Sternchen-Praxis), aber von uns nicht geprüft. Wer Werte wie Terminal Bench v4.0 (38,5 Prozent) liest, sollte das Niveau des Tests bedenken: Selbst der Hersteller-Spitzenwert bleibt weit unter der Hälfte.
Methode
Analyse auf Basis des vollständig gelesenen Hersteller-Blogs, des Vercel-Changelogs und des unabhängigen Release-Trackers; Hugging-Face-Suche nach Gewichts-Repositories ohne Treffer. Alle Benchmark- und Durchsatzwerte sind Herstellerangaben; Vergleichswerte anderer Modelle aus der Herstellertabelle werden nicht als deren eigene Werte wiedergegeben.
Grenzen
Keine eigenen Tests und kein eigener API-Zugriff. Sämtliche Messwerte stammen aus einem einzigen Herstellerbeitrag. Uns ist keine unabhängige Fremdmessung bekannt; zur Verfügbarkeit offener Gewichte liegt keine Herstellerangabe vor.
Quellen
- Introducing LongCat-2.5 - Native Multimodality for Agentic Tasks, Meituan / LongCat (abgerufen 2026-11-03) ↩1 ↩2 ↩3 ↩4 ↩5 ↩6
- LongCat 2.5 now available on AI Gateway, Vercel (abgerufen 2026-11-03) ↩1 ↩2 ↩3 ↩4
- AI Model Releases - November 2026 (Live Tracker), AIFOD / af.net (abgerufen 2026-11-03) ↩1 ↩2 ↩3