 KI
DiffuSpace - ein Team aus dem Umfeld des HKU-NLP-Labors, das mit Dream 7B eines der bekanntesten offenen Diffusions-Sprachmodelle geschaffen hat (2,7 Millionen Hugging-Face-Downloads der Dream-Familie) - hat am 28. Oktober 2026 Clover-35B-A3B-Preview veröffentlicht [1]. Die Leitfrage: Können Diffusionsmodelle auch bei größerer Paramterzahl mit autoregressiven Modellen mithalten, ohne ihren Geschwindigkeitsvorteil zu verlieren? [1]
Clover ist ein textbasiertes Mixture-of-Experts-Modell mit 35 Milliarden Parametern gesamt und etwa 3 Milliarden aktiven pro Token, abgeleitet von Qwen3.6-35B-A3B: hybride Gated-DeltaNet-/Full-Attention-Architektur, 40 Schichten, 256 geroutete Experten, Top-8-Routing, ein geteilter Experte pro Schicht, Thinking-Modus [2][3]. Das Kontextfenster umfasst 128K Tokens für Prompt und Antwort zusammen [2][3].
Architektur: Block-Diffusion mit bidirektionalem Gated DeltaNet
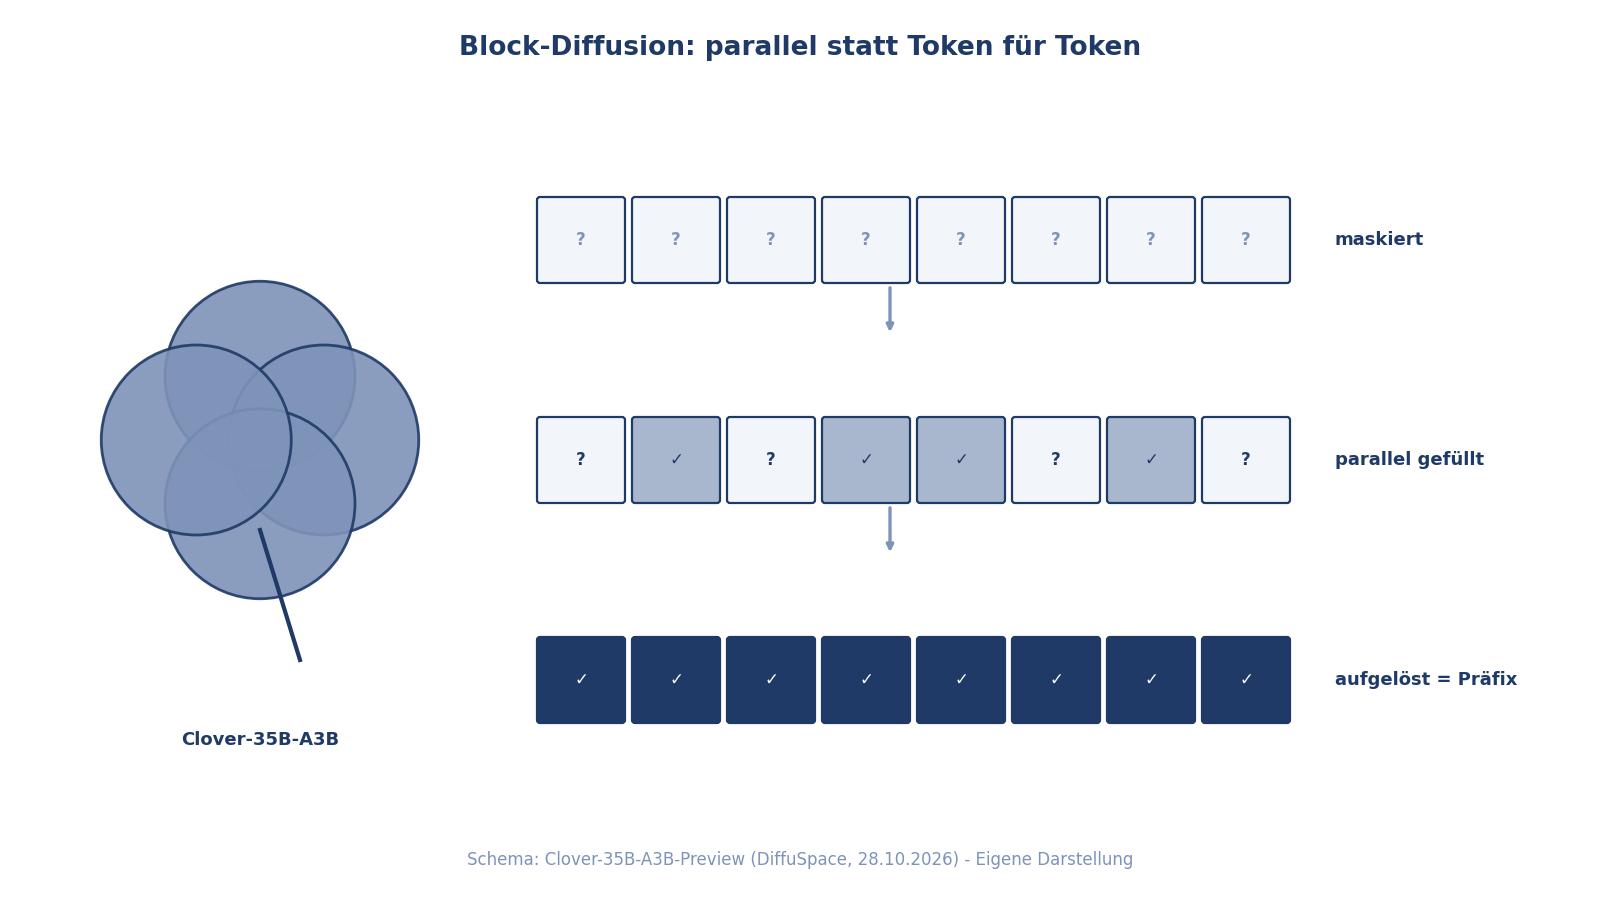
Statt strikt von links nach rechts zu generieren, arbeitet Clover in Blöcken: Jeder Block startet mit maskierten Tokens; Positionen, deren Konfidenz über der Schwelle liegt, werden parallel gefüllt (Standard: block_size=32, Schwellwert 0,95). Aufgelöste Blöcke werden Teil des Präfix für den nächsten Block [2].
Die Struktur dahinter ist ein neu entworfenes bidirektionales Gated DeltaNet: Bereits generierter Kontext wird in den Rekurrenz-Zustand des GDN komprimiert, die Tokens im aktuellen Block interagieren über bidirektionale Softmax-Attention. Den Speicher-Readout behandelt das Modell als eigene Informationseinheit in derselben Softmax - es lernt selbst, wann es auf Historie und wann auf den aktuellen Block setzt. Eine lernbare Blockgrößen-Kalibrierung und ein null-initialisierter Faltungszweig für den rechten Kontext ergänzen das Design [1].
Benchmarks: Bestwerte in der Vergleichsgruppe
In DiffuSpaces eigener Tabelle erreicht Clover in allen sechs Agenten-Benchmarks die höchsten Werte der verglichenen Modelle: SWE-bench Verified 73,6, Terminal-Bench 2.1 51,7 und τ³ Overall 65,3 - vor den Diffusionsmodellen LLaDA2.2 flash und Mercury 2.5 sowie vor Qwen3.6-35B-A3B und Qwen3.5-35B-A3B [1]. Bei den allgemeinen Fähigkeiten nennt der Hersteller GPQA Diamond 83,8, ZebraLogic 95,8, AA-LCR 72,0, MMLU-Pro 84,8 und BFCL-v4 67,9 [1].
Daten als Tabelle
| Clover-35B-A3B-Preview | |
|---|---|
| SWE-b. V. | 73,6 |
| TB 2.1 | 51,7 |
| τ³ Over. | 65,3 |
| GPQA D. | 83,8 |
Ergebnisse aus DiffuSpaces Launch-Tabelle - Herstellerangaben, nicht unabhängig verifiziert [1].
Im Vergleich mit dem gleich großen MiniCPM-V 4.7 (ebenfalls 35B-A3B) liegt Clover um 15,7 Punkte auf Terminal-Bench 2.1 und 28,0 Punkte auf SWE-bench Verified vorn; gegen LFM2.5, Nemotron 3.5 Lightning und Gemma 4 gewinnt es sechs von neun Tests [1]. Wichtig: Alle Werte stammen vom Hersteller; die Modellkarte formuliert entsprechend vorsichtig 'state-of-the-art among open-source diffusion language models at release on the benchmarks reported in our launch blog' [2].
Geschwindigkeit als Kernargument
Der eigentliche Vorteil der Diffusionsarchitektur ist Tempo: Auf einer einzelnen NVIDIA GB300 (BF16, Batch 1) misst DiffuSpace 680 Tokens/s in internen Agenten-Workloads; auf einer H200 erreicht Clover 515 Tokens/s gegenüber 365 für ein DFlash2-beschleunigtes Qwen-Modell [1]. INT4-quantisiert läuft das Modell auf einer RTX 5070 Ti mit nur 16 GB VRAM und erreicht auf MATH-500 101,8 Tokens/s gegenüber 48,5 in der Hersteller-Kontrolle [1]. Für Agenten sei Tempo selbst eine Fähigkeit: Jede Generierungs-Verzögerung multipliziere sich über die Entscheidungsschleifen eines Agenten [1].
Praktisch: Die BF16-Gewichte belegen rund 69 GB; empfohlen wird die offizielle SGLang-Implementierung, da kleine numerische Abweichungen zur HF-Transformers-Referenz zu anderen Generierungen führen können. Inferenz läuft auch über llama.cpp [2][3]. Eine SFT-Spur liegt dem GitHub-Repository bei [3].
Ausblick: Entscheidungsmodell mit Parallel-Modus
Angekündigt ist zudem ein Entscheidungsmodell auf Clover-Basis, das mehrere Fragen zum selben Dokument in einem gemeinsamen Denoising-Durchlauf beantwortet (bis zu acht parallel). In einer internen Validierung mit 500 Gruppen und 2.420 verknüpften Fragen traf der Gemeinschaftsmodus 95,0 Prozent der Einzelfragen gegenüber 89,8 Prozent bei unabhängiger Beantwortung; DiffuSpace argumentiert, gemeinsam erzeugte Urteile widersprächen sich seltener [1]. Das Entscheidungsmodell soll zu einem späteren Zeitpunkt folgen [1].
Methode
Analyse auf Basis des DiffuSpace-Launch-Blogs, der Hugging-Face-Modellkarte und des GitHub-Repositories; alle drei Quellen wurden vollständig gelesen. Sämtliche Benchmark- und Geschwindigkeitsangaben sind Herstellerangaben; das Modell wurde von der Redaktion nicht selbst ausgeführt.
Grenzen
- Keine unabhängige Verifikation der Benchmarks oder Geschwindigkeiten; Vergleichswerte für Qwen, MiniCPM, LFM, Nemotron und Gemma stammen aus DiffuSpaces eigener Tabelle.
- Es handelt sich um eine Preview-Version; das angekündigte Entscheidungsmodell ist noch nicht veröffentlicht.
- Die Dream-7B-Downloadzahl ist eine Herstellerangabe.
Quellen
- Clover-35B-A3B-Preview: A New Way for Intelligence, DiffuSpace (abgerufen 2026-10-29) ↩1 ↩2 ↩3 ↩4 ↩5 ↩6
- Diffuspace/Clover-35B-A3B-Preview - Modellkarte, Hugging Face / DiffuSpace (abgerufen 2026-10-29) ↩1 ↩2 ↩3 ↩4 ↩5
- DiffuSpace/Clover-35B-A3B-Preview - Repository, GitHub / DiffuSpace (abgerufen 2026-10-29) ↩1 ↩2 ↩3 ↩4 ↩5