 KI
Fachüberblick am Abend, 30. Oktober 2026. Quellenstand: 16:01 Uhr MEZ. Diese Ausgabe behandelt drei Veröffentlichungen vom 28. und 29. Oktober: Hugging Faces Swift-Pakete für offene Sprach- und Entscheidungsmodelle auf Apple-Plattformen, Amazons neue Gerätegeneration mit erweiterter Sensorik und den DecoyCount-Benchmark von Elorian und Mercor. Die verbindende Frage lautet, wie belastbar die jeweils mitgelieferte Evidenz ist.
1. AnySpeechRecognizer und AnyDecisionModel: Engine-Wahl statt Systembindung
AnySpeechRecognizer bildet Apples SpeechAnalyzer-API (iOS 26/macOS 26) nach, ersetzt aber die einzige darunterliegende Engine durch wählbare Modelle: Nvidias Parakeet v3 (25 europäische Sprachen, automatische Spracherkennung), Moondreams nachjustiertes Parakeet Ultra, Nvidias englisch-only Parakeet Unified und Alibabas Qwen3-ASR (30 Sprachen, 22 chinesische Dialekte, segmentweise bis 40 Sekunden, GPU-gebunden und langsamer). Die Parakeet-Varianten laufen auf einer eigenen Core-ML-Laufzeit mit Datei- und Liveeingang, Wortzeitstempeln und Konfidenzwerten; ein 8-Sekunden-Encoder senkt die Live-Analysezeit um etwa ein Drittel bei leicht höherer Fehlerrate. Eine Sortformer-basierte Diarisierung ordnet bis zu vier Sprecher zu, auch überlappend, eine Funktion, die Apples Framework nicht anbietet. Alle Konvertierungen liegen mit Quell-Checkpoint, Prüfsummen und fester Revision auf dem Hub, Lizenzen: CC BY 4.0, Apache 2.0 und NVIDIA Open Model License [1].
Die Messlage ist transparent und eng: Auf einem M4 Max unter macOS 27.0.1 erreichen die Parakeet-Varianten auf LibriSpeech test-clean 1,43 bis 1,66 Prozent Wortfehlerrate (Apples Engine 2,12), auf test-other 2,19 bis 2,78 (Apple 3,97). Auf AMI-Meeting-Aufnahmen mit Überschneidungen liegen alle Engines über 23 Prozent. Es handelt sich um eine Ein-Maschinen-Selbstmessung, die sich mit dem mitgelieferten Werkzeug reproduzieren lässt; iOS wurde bisher nicht getestet. AnyDecisionModel schließlich beantwortet Ja-Nein-, Mehrfachauswahl- und Skalenfragen, indem es die Wahrscheinlichkeiten der Antwort-Labels in einem einzigen Forward-Pass ausliest; Ergebnisse sind typisiert, mit Wahrscheinlichkeiten und Konfidenz, Fragen sind untereinander unabhängig [1].
2. Amazon Echo: Sensorik als Produktgrenze
Amazons Geräteankündigung zeigt, wo die Verarbeitung künftig stattfindet: Der Echo Dot bekommt den eigenen AZ3-Chip mit KI-Beschleuniger für Gesprächserkennung und Geräuschfilterung auf dem Gerät, dazu Smart-Home-Hub und eero-Erweiterung. Der Echo Studio erhält erstmals eine Kamera; beworben werden das Vorlesen von Spielregeln vom Karton, das Wiedererkennen von Produkten für Nachbestellungen und ein Fernzugriff auf den Raum per App. Der Wecker Echo Time verzichtet bewusst auf eine Kamera und misst per Ultraschall (Omnisense) Atmung und Schlafphasen, mit Zertifizierung der National Sleep Foundation. Fotorahmen und Echo Show 16 bleiben vorerst US-Markt; Studio, Time und Dot kommen auch nach Deutschland. Viele Funktionen setzen Alexa+ voraus [2][3]. Welche Sensordaten das Gerät jeweils verlassen und welche lokal bleiben, beantwortet die Ankündigung nicht; das ist zum Quellenstand nicht belegt und vor einer Bewertung im eigenen Haushalt zu klären.
3. DecoyCount: Sehfehler und Denkfehler getrennt gemessen
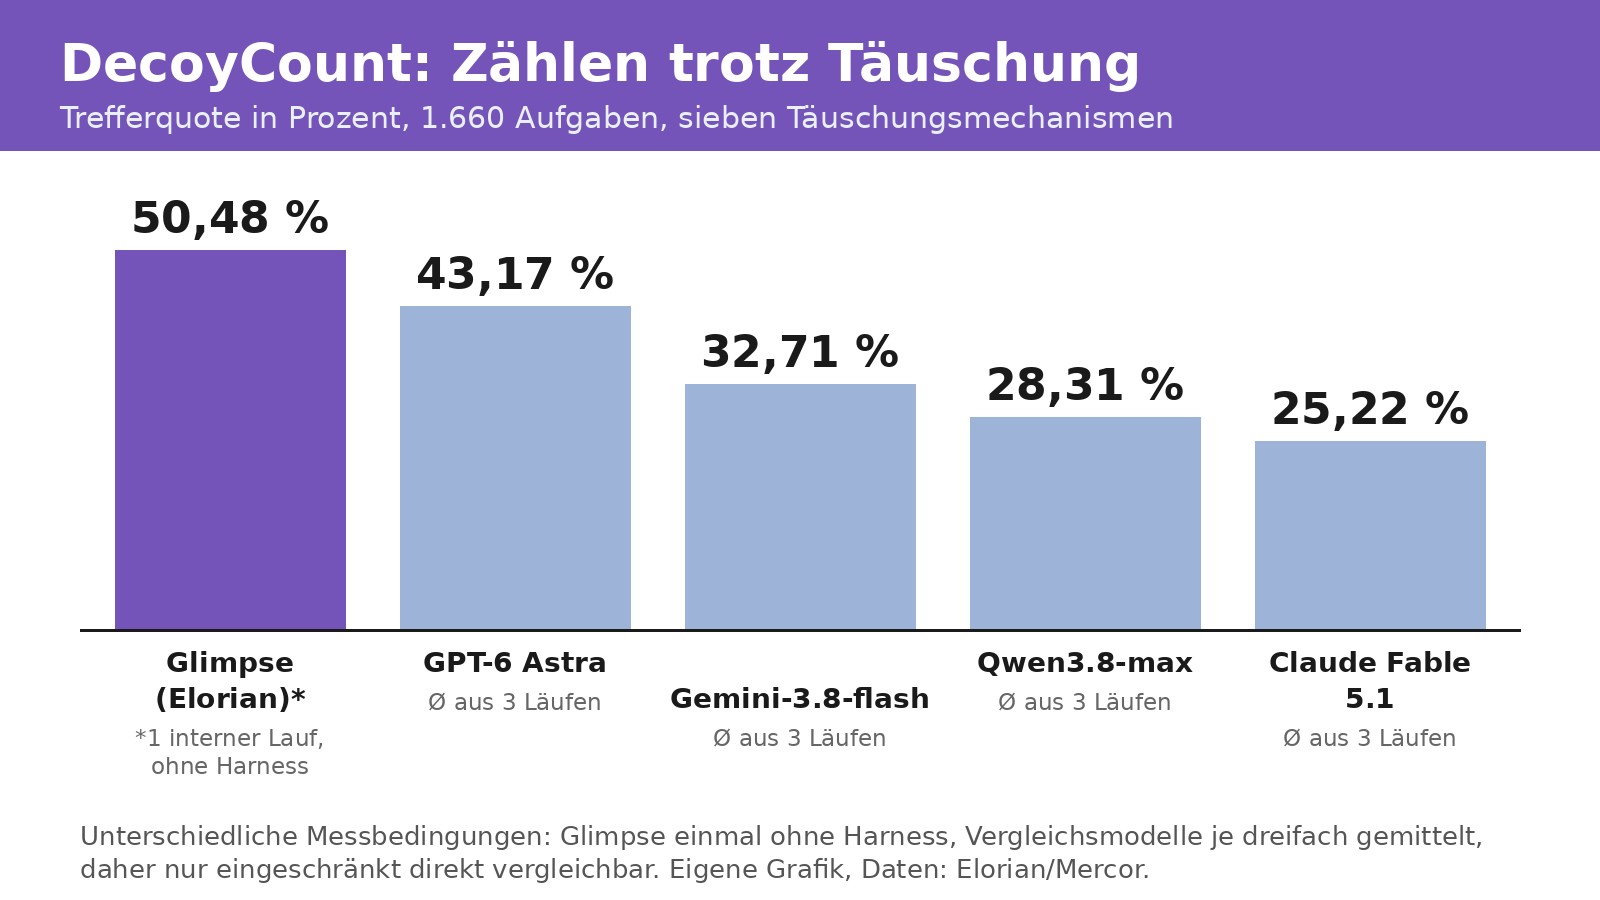
Der von Elorian und Mercor veröffentlichte DecoyCount-Benchmark prüft über 1.660 Aufgaben und sieben Täuschungsmechanismen, ob Modelle Objekte wirklich zählen oder Heuristiken folgen, etwa Spiegelungen, Verpackungsangaben oder erwartete Stückzahlen. Methodisch bemerkenswert ist die Fehlertrennung: Ein übersehenes Objekt (Sehfehler) und eine doppelt gezählte Spiegelung (Denkfehler) werden nicht zur selben Fehlerklasse addiert. Ergebnis der Begleitveröffentlichung: Keines der im Paper verglichenen Spitzenmodelle kommt über 50 Prozent; GPT-6 Astra erreicht 43,17, Gemini-3.8-flash 32,71, Qwen3.8-max 28,31 und Claude Fable 5.1 25,22 Prozent. Der Schluss der Autoren: Stärkeres allgemeines Reasoning generalisiert nicht von selbst zu ausgerichtetem visuellen Reasoning [4].
Zur Bewertung des Spitzenwerts: Elorian meldet für Glimpse 50,48 Prozent, gemessen in einem internen Einzellauf ohne Agenten- oder Werkzeug-Harness, während die sechs Vergleichsmodelle über jeweils drei Läufe gemittelt wurden. Die Evaluationsbilder seien laut CEO Andrew Dai aus dem Training ausgeschlossen und per Kontaminationsprüfung verifiziert worden, ein externer Beleg steht aus. Hinzu kommt die Interessenlage: Benchmark und Spitzenmodell stammen vom selben Anbieter. Der Befund zur Fehlertrennung bleibt davon unberührt und ist unabhängig von Glimpses Platzierung verwertbar [4].
Unsere Einordnung: Drei Evidenzgrade am selben Tag
Hugging Face liefert die stärkste Position: eine Selbstmessung mit veröffentlichtem Werkzeug, die sich auf eigener Hardware falsifizieren lässt, inklusive der ehrlichen Meeting-Grenze. Amazon liefert eine Produktankündigung, deren Sensorik-Fakten prüfbar sind, deren Datenwege aber unbeschrieben bleiben. DecoyCount liefert einen methodisch wertvollen Benchmark mit einem Spitzenwert, dessen Bedingungen die Vergleichbarkeit einschränken. Die Prüffrage bleibt die der letzten Ausgaben: Was ist reproduzierbar, was ist belegt, was ist vorerst Behauptung?
Vertiefend: Wie Bildmodelle lernen: Diffusion, Tokenizer und Stile und Eigene KI-Dienste absichern: Zugriff, Datenflüsse, Updates.
Quellen
- Introducing AnySpeechRecognizer and AnyDecisionModel: Open Models for Speech and Decisions on Apple Platforms, Hugging Face Blog (abgerufen 2026-10-30)
- Amazon unveils its newest lineup of Alexa devices, About Amazon (abgerufen 2026-10-30)
- Can Frontier Models See Past a Decoy? Elorian Tests Visual Reasoning, Latent Space (abgerufen 2026-10-30)
- KI-Update kompakt: Mistral ML4, Cohere, KI-Empfehlungen, KI klont Indie-Spiele, heise online (abgerufen 2026-10-30)