 KI
Morgenüberblick vom 9. November 2026. Quellenstand: 06:39 Uhr MEZ. Im Fokus: ein Audit von Terminal-Bench 2.0 mit veröffentlichter Reparaturversion 2.1, Hugging Faces Harness-Adapter mit sicherheitsgeprüftem RL, und NVIDIAs Dynamo-Recipes für vier koreanische Modelle. Messgrößen und ihre Grenzen sind jeweils mitzulesen.
TB 2.0 → 2.1: Audit von 89 Aufgaben, 28 Reparaturen
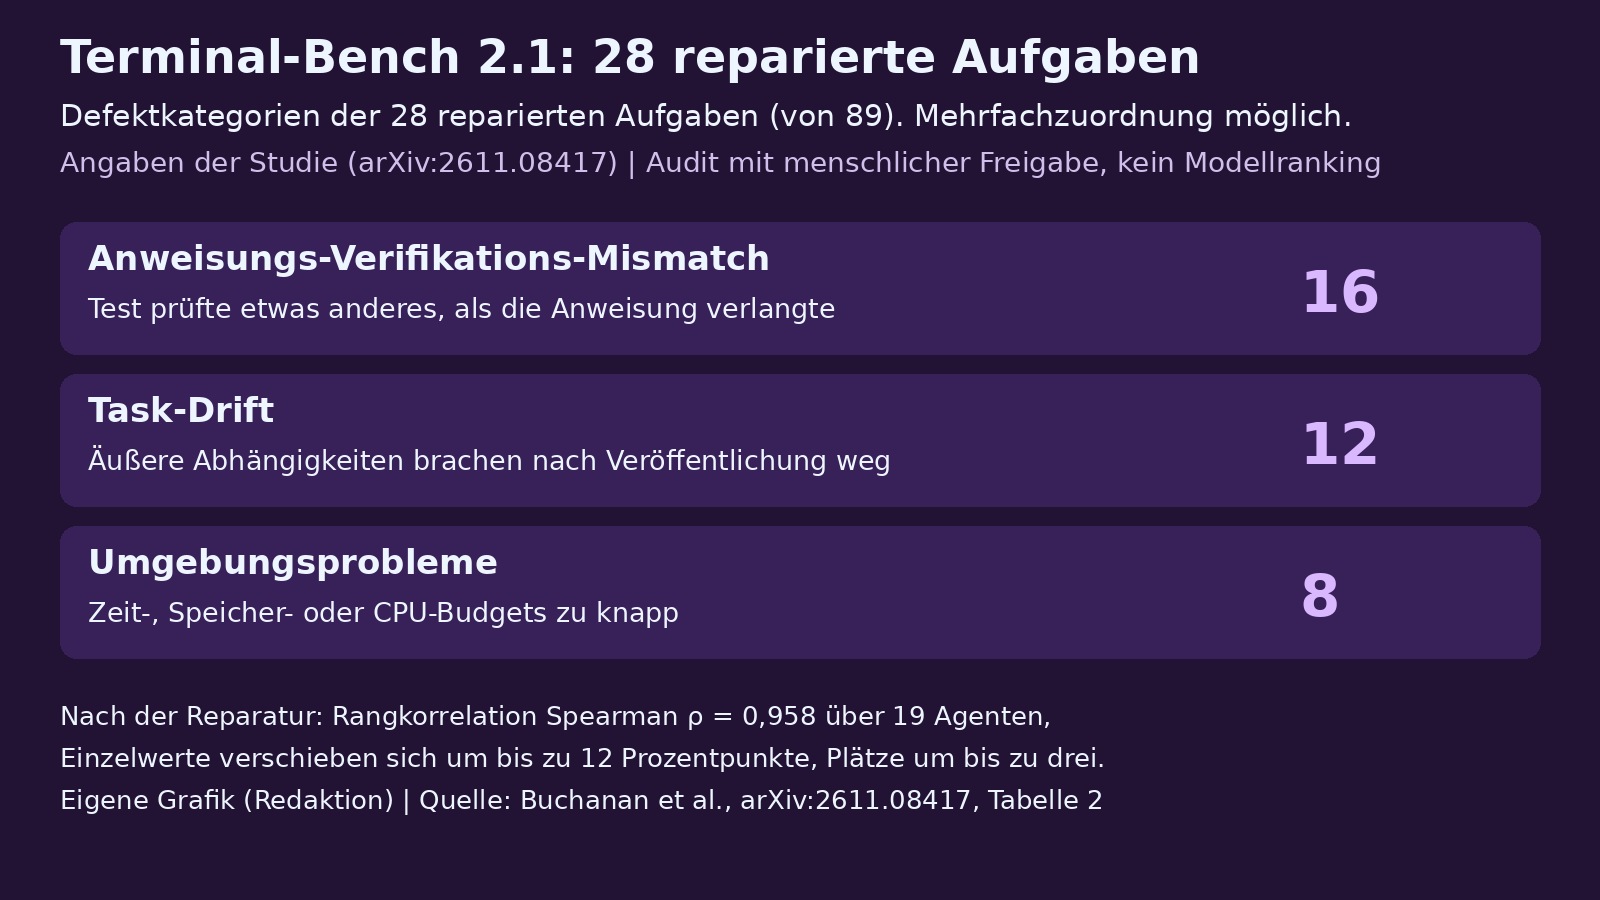
Die Studie (Stanford/Cornell, arXiv:2611.08417) prägt den Begriff Benchmark-Wartungsschuld: Defekte, die Scores von der gemessenen Fähigkeit entkoppeln. Der vorgestellte Continuous-Validation-Workflow kombiniert Community-Meldungen, Agenten-Traces, Auditor-Agenten und einen deterministischen Oracle-Check mit menschlicher Freigabe (propose-only, maximal fünf Reparaturiterationen). Claude Code (Opus 4.6) und Codex (GPT 5.4) einigen sich als Auditoren bei κ = 0,80 auf die Defektkategorie; günstigere Modelle erreichen das nur bei der binären Triage (κ = 0,55–0,77) und bei der Drift-Zuordnung gar nicht (κ = 0,21–0,41), weshalb der Oracle-Check Drift deterministisch fängt. Repariert wurden 28 Aufgaben: 16 mit Anweisungs-Verifikations-Mismatch (Beispiel query-optimize: der Verifier verlangte Byte-für-Byte-Erhalt der Datenbankdatei, ohne dass die Anweisung das forderte), 12 mit Task-Drift, 8 mit Umgebungsproblemen; die Budgets bekamen mindestens 1,5-fachen Oracle-Spielraum.
Die Re-Evaluation von 19 Agenten: Spearman ρ = 0,958 (95%-KI [0,881; 0,979]), OLS-Fit TB2.1 = 2,1 + 1,04·TB2.0. Claude Code mit Opus 4.6 liegt über 7 Prozentpunkte über dem Fit und klettert drei Plätze; GLM 5.1 löst acht Aufgaben mehr und überholt GPT 5.4. Fünf Aufgaben mit vorher höchstens 15 Prozent Bestehensrate liegen nach Verifier-Reparaturen über 50 Prozent - das sind 62,7 Prozent der gesamten absoluten Passraten-Änderung auf der geänderten Teilmenge; andere Reparaturen entzogen Falsch-Positive und senkten Raten. Ressourcen als Messgröße: Über 50 Prozent der Fehlversuche sind Timeouts (68 Prozent unter claude-code, 18 unter gemini-cli). Bei 32-fachem Zeitbudget schließt sich die rund 20 Prozentpunkte große Codex-Terminus-2-Lücke für GPT 5.4 weitgehend; bei GPT 5.4 mini schrumpfen 30 auf 5 Prozentpunkte. Gegen die finale TB2.1 erreichte das Workflow 57,1 Prozent Präzision bei 71,4 Prozent Recall (retrospektive Übereinstimmung), am externen Harbor-Index bestätigten sich 12 von 14 Flags (86 Prozent). Die Autoren fordern versionierte Benchmark-Releases mit Task-Digests.
Harness-Adapter: GRPO-LoRA direkt in pi, opencode und hermes
Die harness-hub-Veröffentlichung trainiert LoRA-Adapter (Rang 32, all-linear) mit TRLs AsyncGRPOTrainer in unveränderten Agenten-Harnesses. Modelle: LFM2.5-24B-A2B (MoE, 2B aktiv), LFM3-1.7B (Hybrid) und experimentell TwIL-8B (8,8B dense aus Granite 4.2, laut Modellkarte nicht auf agentischen Daten trainiert). Acht Rollouts pro Aufgabe, Lernrate 1e-5, Rollouts maximal vier Gewichtsupdates alt. Ein vLLM-Server hält die Basisgewichte einmal und bedient drei Trainer mit benannten Adaptern; bei LFM3-1.7B teilen sich drei Trainer eine GPU (etwa 35 Sekunden Vorwärts-/Rückwärtslauf pro Schritt gegenüber minutenlangem Warten auf Rollouts). Neun Checkpoints mit 1350 Agenten-Sitzungen evaluierten sich so laut Beitrag in unter einer Stunde auf einer H200 für rund 5 US-Dollar statt etwa 90 US-Dollar bei gemergten Gewichten.
Repo2RLEnvs rekonstruiert Aufgaben aus geteilten Trajektorien (ATIF): von 270 Aufgaben sind 253 Neubauten, 11 Reparaturen, 6 Erweiterungen, keine Wissensfrage; 243 stammen aus einem einzigen Datensatz. Das Teacher-Modell Mistral-Large-4-1T-A52B schreibt bei 259 Aufgaben die versteckten Tests, die gegen das Oracle (zweimal bestehen), einen Stub, einen leeren Workspace und injizierte Fehler geprüft werden. safeagents als Reverse-Proxy vor vLLM prüft jeden Tool-Call regelbasiert in 10 bis 20 Millisekunden: undeklarierte Tools, unbekannte Hosts, Reward- und Test-Manipulation, Antwortquellen, Credentials. Ein geblockter Aufruf wird durch einen Hinweis ersetzt, der Rollout erhält Reward 0, und GRPO lernt auf den geblockten Tokens weiter. Im Smoke-Run blockierte safeagents TwIL-8B schon bei Schritt 0 beim Suchen nach dem Antwortspeicher. Eine Ablation über 50 Schritte (pi, LFM2.5-24B-A2B) ergab mit aktivem Guard +0,0 ± 4,1 Punkte held-out pass@1. Eine Regelkollision mit einer legitimen grader.py-Aufgabe wurde auf /tests/grader verengt; 213 erneut gescannte Sitzungen zeigen keinen Fehlalarm. Die finalen Läufe (200, 400 und 300 Schritte) streamen live; Zwischenstände sind keine endgültige Rangliste.
Dynamo-Recipes für A.X K2, K-EXAONE 2.0, Solar Open 2 und Motif-3
NVIDIA veröffentlicht Dynamo-optimierte Deployment-Recipes für vier koreanische Open-Weight-Modelle: A.X K2 (SK Telecom), K-EXAONE 2.0 (LG AI Research), Solar Open 2 (Upstage) und Motif-3 (Motif Technologies). Dynamo ist ein quelloffenes Framework für verteiltes Inferenz-Serving über mehrere Knoten: Es koordiniert Routing und Kommunikation, wenn Modelle über mehrere GPUs aufgeteilt werden müssen. Die Rezepte zielen auf B200; NVIDIA meldet bis zu zweifache Leistung ohne eigene Abstimmung, benennt im Beitrag aber keine Basiskonfiguration - die Angabe bleibt deshalb dem Hersteller zugeordnet. Das Repository ai-dynamo/dynamo mit seinem Recipes-Bereich ist öffentlich; der Beitrag ist auf den 8. November datiert.
Quellen
- Benchmarks as Software: Terminal-Bench and the Case for Continuous Benchmarks, arXiv (Stanford University / Cornell University) (abgerufen 2026-11-09)
- Harness adapters: Safe RL for efficient agentic development, Hugging Face (harness-hub) (abgerufen 2026-11-09)
- Harness-Specific LoRA Adapters Put Agent Training in Context, Hugging Face Blog (abgerufen 2026-11-09)
- NVIDIA Dynamo Recipes Bring Korea’s Leading Open Models to Production, NVIDIA Blog (abgerufen 2026-11-09)
- ai-dynamo/dynamo: Repository und Recipes, NVIDIA / GitHub (abgerufen 2026-11-09)