 KI
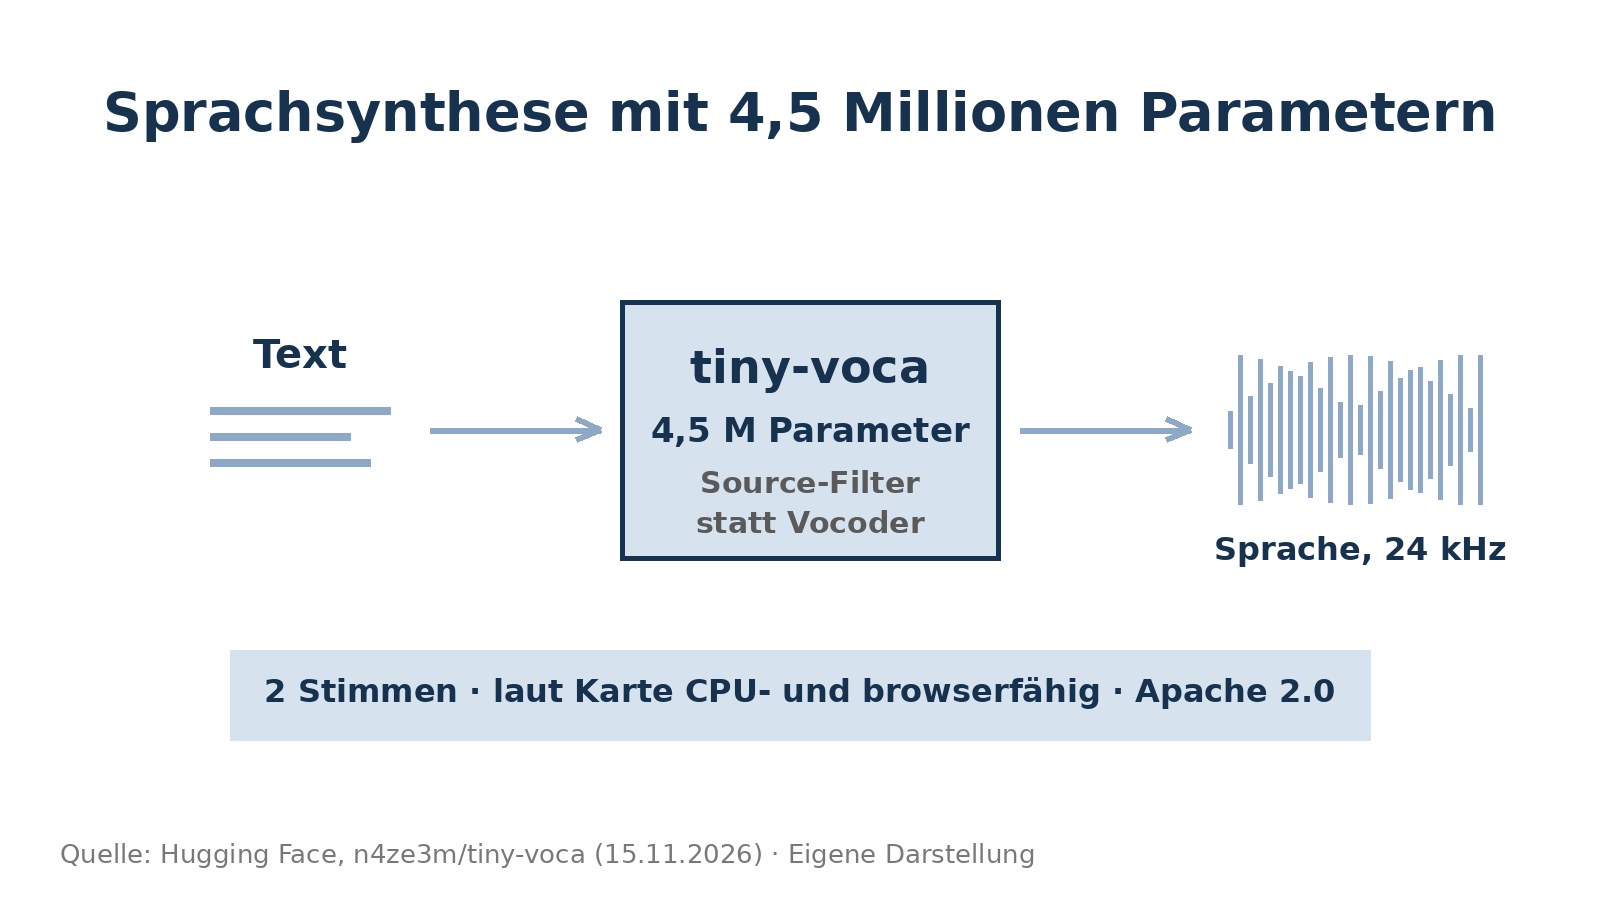
Wie klein kann Sprachsynthese sein, ohne unbrauchbar zu werden? Die Antwort von Muhammed Nazeem: 4.537.291 Parameter, inklusive der Wellenform-Erzeugung. Sein Modell tiny-voca erschien am 14. November 2026 auf Hugging Face (Repository-Anlage laut Plattform-API) und erzeugt englische Sprache in zwei Stimmen mit 24 kHz - laut Modellkarte etwa 70-mal schneller als Echtzeit auf vier CPU-Threads [1]. Gewichte und Code stehen unter Apache 2.0 [1][3].
Architektur: Synthese statt neuronalem Vocoder
Der Weg vom Text zum Klang: Ein Phonemisierer (dizione, ebenfalls Apache 2.0) wandelt Text in Phonem-IDs mit Betonungswerten um; ein Transformer-Encoder aus vier Blöcken liest die Phoneme, ein Prädiktor vergibt Dauern, und zwei Transformer auf Frame-Ebene (zwei beziehungsweise fünf Blöcke) sagen Tonhöhe, Stimmhaftigkeit, Energie und die Parameter der Klangerzeugung voraus - alle Blöcke mit 192 Kanälen, vier Köpfen und Rotary-Embeddings [1]. Die Welle selbst entsteht in einem klassischen Source-Filter-Synthesizer: Ein bandbegrenzter Impulszug in der vorhergesagten Tonhöhe und ein Rauschsignal laufen durch einen zeitvarianten Filter, dessen Cepstrum das Netz einmal pro Frame (256 Samples, etwa 10,7 Millisekunden) vorhersagt. Dieser Teil kommt mit 25.862 Parametern aus [1].
Daten als Tabelle
| Parameter | |
|---|---|
| Embeddings | 16704 |
| Text-Encoder | 1588864 |
| Dauer-Prädiktor | 123906 |
| Frame-Transformer A | 795971 |
| Frame-Transformer B | 1985984 |
| Source-Filter-Kopf | 25862 |
Herstellerangaben aus der Modellkarte; Gesamtsumme 4.537.291 Parameter inklusive Wellenform-Erzeugung [1].
Eckdaten
4.537.291 Parameter gesamt · zwei Stimmen (F2 weiblich, M2 männlich, amerikanisches Englisch) · Ausgabe 24 kHz mono · eine Äußerung pro Aufruf, bis 512 Token und 32 Sekunden · PyTorch-Gewichte 18,2 MB (float32), ONNX-Export 21,4 MB (opset 17) · Steuerung über Sprechrate, Tonhöhenverschiebung (0,058 entspricht etwa einem Halbton) und Tonhöhenumfang · Lizenzen: Gewichte und Code Apache 2.0, Datensatz CC BY 4.0, Phonemisierer-Daten mit eigenen Lizenzdateien (CMU Pronouncing Dictionary und weitere) [1][2][3].
Der ONNX-Graph nimmt Phonem-IDs und Betonung entgegen und liefert die Wellenform direkt; laut Karte läuft dieselbe Datei in onnxruntime-web per WebAssembly und weicht höchstens 0,6 Prozent der Spitzenamplitude vom PyTorch-Modell ab (abgesehen vom Rauschsignal, das jede Laufzeitumgebung selbst zieht) [1]. Damit ist ein Betrieb ohne Server möglich - etwa im Browser oder auf dem Telefon, wo Text das Gerät nicht verlassen muss; das ist eine Betriebsmöglichkeit, keine Eigenschaft, die wir selbst geprüft hätten.
Training: 7,7 Stunden auf einer RTX 4090
Ungewöhnlich ist die Datenlage: Die 16.018 Clips (17,6 Stunden, zwei Stimmen) sind komplett synthetisch. Beide Stimmen wurden aus Textbeschreibungen mit Qwen3-TTS VoiceDesign entworfen und mit Qwen3-TTS 1.7B Base gerendert; keine Aufnahme eines echten Menschen steckt im Modell [1][2]. Die Phonemdauern stammen aus Forced Alignment mit wav2vec2 (nur zur Beschriftung); vortrainierte Gewichte sind laut Karte nicht Teil des Modells - tiny-voca wurde von Grund auf trainiert: 104.737 Schritte, 7,7 Stunden auf einer RTX 4090, spektrale Verluste plus adversariale Verluste ab Schritt 8.000 [1].
Qualität: Plausibilitätscheck statt Benchmark
Die Karte dokumentiert als einzige Auswertung die Wortfehlerrate der Synthese, transkribiert mit Whisper small.en, gegen Referenzaufnahmen derselben Sätze: 0,6 Prozent auf acht Validierungsclips (Referenz ebenfalls 0,6), 0,9 Prozent auf acht Testclips (Referenz 0,9) und 0,0 Prozent auf 16 neuen Sätzen [1]. Der Entwickler selbst nennt das einen Sanity Check auf kleinen Mengen - ein formeller Hörtest wurde nicht durchgeführt [1]. Die Karte listet zudem offen die Grenzen: nur Englisch, zwei feste Stimmen, kein Stimmenklonen, deterministische Prosodie, leicht synthetischer Klang, Aussprache von Namen und Zahlen hängt am Phonemisierer, kein Streaming, und die natürlichere Obergrenze setzt das synthetische Trainingsmaterial [1].
Einordnung
tiny-voca besetzt das entgegengesetzte Ende dessen, was wir zuletzt bei ZONOS3-Mini gesehen haben: Dort 100 Millionen aktive Parameter für Stimmenklonen in 43 Sprachen, hier 4,5 Millionen für zwei feste englische Stimmen. Der Wert liegt woanders - im vollständig offenen, von Grund auf trainierten und bis zur Wellenform dokumentierten Aufbau, in 18 bis 21 Megabyte Dateigröße und in der Betriebsmöglichkeit ganz ohne GPU und ohne Cloud. Wer mehrsprachige Qualität oder Klonen braucht, ist hier falsch; wer eine winzige, lizenzfreundliche Stimme für Geräte und Browser sucht, bekommt ein selten vollständig nachvollziehbares Beispiel.
Methode
Recherche am 15. November 2026 gegen 6 Uhr UTC (7 Uhr MEZ): Modellkarte und Plattform-API von tiny-voca, Plattform-API des Trainingsdatensatzes sowie die GitHub-Repositories von tiny-voca und dizione, alle selbst geöffnet und gelesen. Eigene Tests haben wir nicht durchgeführt; die Audioproben auf der Karte haben wir nicht abgespielt.
Grenzen
Alle Leistungs- und Qualitätsangaben stammen vom Entwickler. Die Wortfehlerraten-Auswertung umfasst nur 8 bis 16 Clips und ist laut Karte ein Plausibilitätscheck, kein Benchmark; ein formeller Hörtest fehlt. Die Browser-Lauffähigkeit und die Tempoangabe haben wir nicht nachgeprüft.
Quellen
- n4ze3m/tiny-voca (Modellkarte und Plattform-API), Hugging Face (abgerufen 2026-11-15) ↩1 ↩2 ↩3 ↩4 ↩5 ↩6
- n4ze3m/tiny-voca (Trainingsdatensatz, Plattform-API), Hugging Face (abgerufen 2026-11-15) ↩1 ↩2
- n4ze3m/tiny-voca (Code, Repository-API), GitHub (abgerufen 2026-11-15) ↩1 ↩2