 KI
Abendüberblick vom 9. November 2026. Quellenstand: 16:01 Uhr MEZ. Drei Preprints: Requirement-to-Artifact-Evaluation für Designagenten, ein dreistufiger 3D-Benchmark mit Laufzeittests und ein Resampling-Verfahren, das Self-Consistency-Tokens einspart. Wir haben die Experimente nicht selbst wiederholt.
DRAFT-Bench: Evidenzschichten statt Gesamtscore
DRAFT-Bench (UMD/Curify, arXiv:2611.08933) verknüpft jede aktive Anforderung mit der relevanten Artefaktversion und ihrem Beleg: strukturelle Evidenz (Vorhandensein, Format, Versionsidentität), semantische Evidenz (angeforderte Änderung, Schutzeigenschaften) und Workflow-Evidenz (finale Ausgabe, deklarierte Kundenabhängigkeit). Setup: Codex CLI 0.154.0 mit gpt-6-astra gegen Claude Code 2.1.286 mit claude-opus-5-5, je max effort, 60 Minuten Aktivlimit pro Zug (kein Projektbudget). Astra schließt 43/43 Bedingungen ab, Claude 35/43 (acht First-Turn-Timeouts); Median der First-Turn-Dauer: Claude 41,4 Minuten, Astra 15,8 Minuten; Claude inklusive der Zeitüberschreitungen. Alle bewerteten Kernläufe erhalten strukturell 1,0, semantische Checks (Gemini 2.5 Pro, Temperatur 0) flaggen 13/32 Astra- und 5/28 Claude-Bedingungen, auf den 28 gemeinsamen 11/28 zu 5/28 - Modellurteile, keine Expertenlabels; Full-Score-Bounds [0,655; 0,912] vs. [0,711; 0,968] überlappen so, dass beide Reihenfolgen drin sind.
Die 40 RFQ-Szenarien (simulierte Kunden, fixe Antworten) zeigen kohortenabhängige Reihenfolgen: original 18/20 Claude vs. 17/20 Astra, in den 19 zusätzlichen gepaarten 19/19 Astra vs. 16/19 Claude; kombiniert gepaart 36/39 zu 34/39. Die Fallstudien sind methodisch der Kern: SKU-Erweiterung erst nach Kundenwahl aktiv, Feedback mit nicht etablierter Versionsvoraussetzung (BID-001), White-Separation im PDF ohne Druckfreigabe; ein historischer Rejudging-Pilot (7 Paare) zeigt, dass geänderte Akzeptanzregeln Urteile von 16/100 auf 100/100 kippen, ohne dass sich ein Artefakt änderte. Konfundierungen benannt: Werkzeuge, Laufzeit, Isolation, Datum, ein Lauf pro Bedingung, Judge-Policywechsel zwischen den Systemläufen ohne Rerun. Aufgaben und Toolkit auf GitHub; die veröffentlichten Materialien reichen laut Paper nicht aus, um sämtliche historischen Designurteile zu rekonstruieren.
Frontier3DBench: 145 Aufgaben, drei Stufen, Laufzeittests
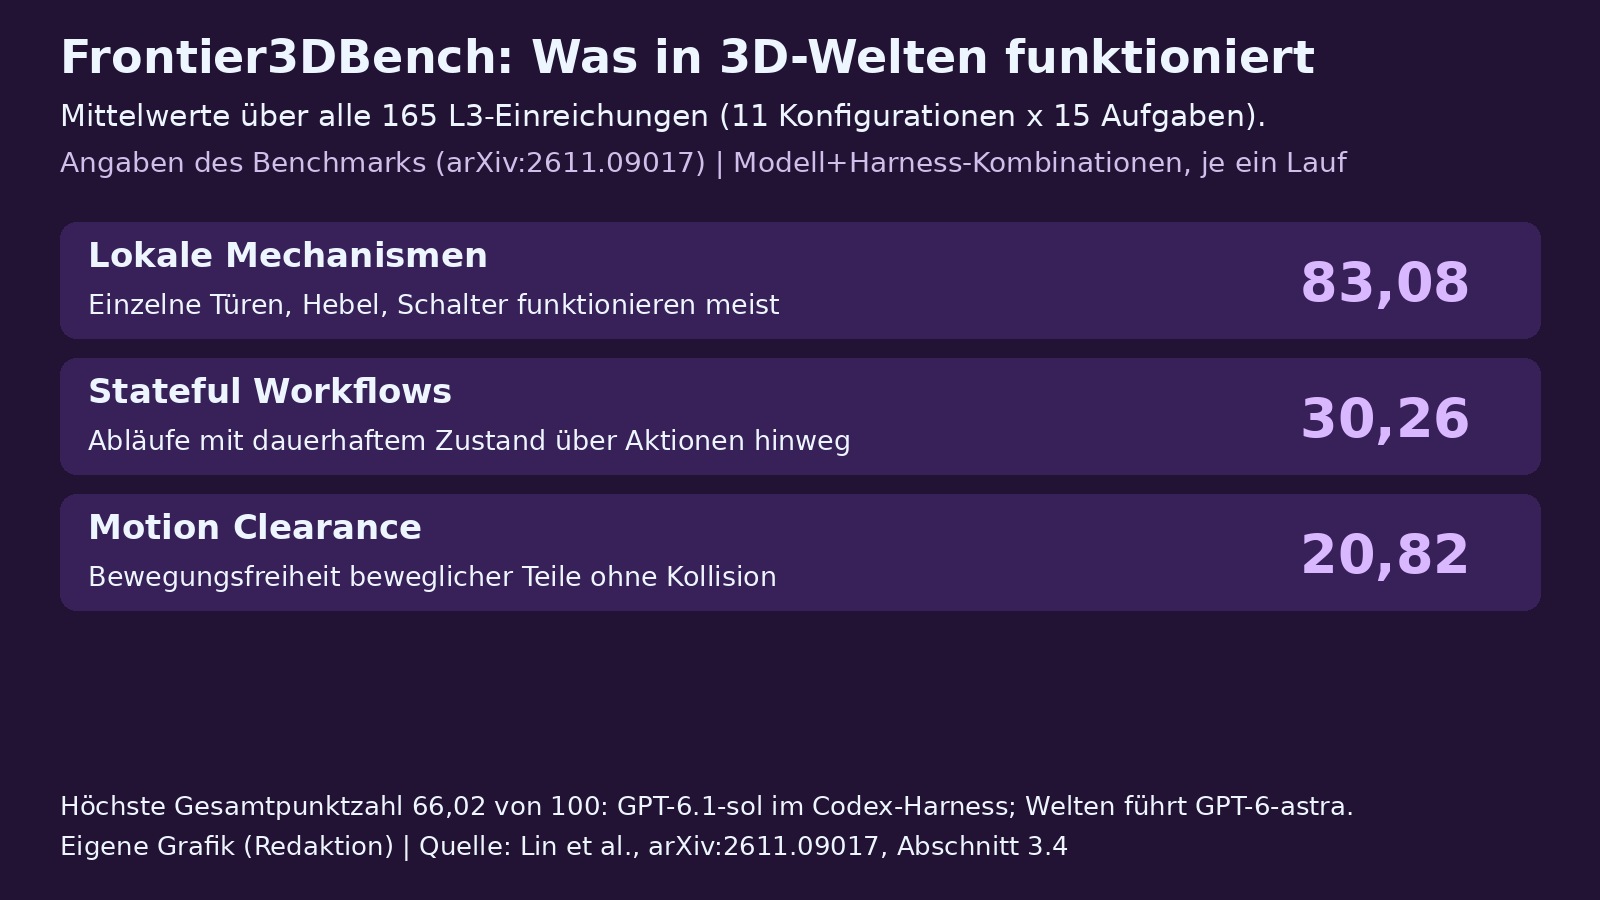
Frontier3DBench (Einsia/Tsinghua, arXiv:2611.09017) prüft 11 Modell-Harness-Konfigurationen auf 145 Aufgaben: L1 Objekte (15 Text2Code, 25 Multi-View-, 25 Single-View-Rekonstruktion), L2 Szenen (20 Brief2Scene, 10 Ref2Scene, 25 RealPhoto, 10 SceneEdit) in Blender, L3 fünf Text2Env- und zehn Img2Env-Welten mit Interaktionsvertrag in Unreal Engine. Bewertet wird dreifach: gerenderte Ansichten (Optik), Szeneninspektion (Struktur), unabhängige Laufzeittests (Verhalten inklusive Zustandspersistenz). Gesamt führt GPT-6.1-sol/Codex mit 66,02 vor GPT-6-astra/Codex 63,85 und Opus 5.5/Claude Code 62,29; Kategoriensiege verteilen sich auf drei Konfigurationen (Sol sechs, Astra die beiden L3, Opus Text2Code mit 84,05). Alle Konfigurationen liegen bei Referenzrekonstruktion unter ihrer Generierungsleistung (Text2Object 75,93 bis 84,05 vs. beste Multi-View-Rekonstruktion 69,61).
Die L3-Zerlegung über alle 165 Submissions: lokale Mechanismen 83,08, Motion Clearance 20,82, Stateful Workflows 30,26 - Einzelmechanik funktioniert, koordinierte Aktivitäten mit persistentem Zustand nicht. Dimensionen separat: Opus führt L1-Struktur (83,27), Sol L1/L2-Optik und L2-Struktur, Astra L3-Layout (86,37) und L3-Optik (57,37). Mensch-Score-Abgleich: acht Bewerter, 45 Items aus vier referenzgebundenen L1-/L2-Aufgabenfamilien, 360 Rankings, Kendall-Tau-b 0,727 im Mittel (Top-1-Treffer 79,2 %), über der Bewerter-untereinander-Rate 0,679; bei Scoreabstand ≥30 Punkte steigt die Übereinstimmung auf 0,793. Werte sind Modell-plus-Harness aus je einem Lauf.
StepBack: Suffix-Resampling ab erstem Fehlschritt
StepBack (NC State, arXiv:2611.08403) ersetzt das Voll-Neuziehen aller 32 SC-Spuren: 16 Drafts werden an Leerzeilen in Schritte zerlegt, ein Signal lokalisiert den ersten verdächtigen Schritt (NLL-Anstieg > 0,1 oder PRM-Abfall > 0,05, Qwen2.5-Math-PRM-7B), Prefix bleibt, Schritt plus Suffix wird neu gesampelt; ohne Befund nur der Antwortschritt. Budget exakt SC@32 (16 mal 2). Über 4.166 Fragen in fünf Mathe- und zwei Multi-Hop-Benchmarks auf Llama-3.2-3B, Qwen2.5-3B und Qwen2.5-7B: PRM-Signal: modellweise mittlere Genauigkeitsgewinne von +0,17 bis +0,82 Prozentpunkten und 18,66 bis 22,80 Prozent weniger Tokens; NLL-Signal -27,74/27,15/33,32 Prozent bei maximal -0,17 Punkten; PRM spart in allen 21 Modell-Datensatz-Paaren Tokens (7,66 bis 41,26 %), verliert jedoch in sechs Paaren an Genauigkeit. Der Höchstwert 41,26 Prozent gehört zu Qwen-7B/GSM8K mit +0,45 Prozentpunkten Genauigkeit. Lokalisierungs-Overhead 7 bis 11 Prozent der GPU-Wallclock. Oracle-Obergrenze mit annotierten Erstfehlern: 31,2 bis 64,0 Prozent Ersparnis bei paritätischer Genauigkeit.
Kombinierbar mit AC/ESC/DSC (Suffix-Pool statt Vollspuren): weitere Tokenersparnis gegenüber der adaptiven Methode allein: 22 bis 24 Prozent auf MATH500, 35 bis 38 Prozent auf GSM8K und 6 bis 7 Prozent auf HotpotQA; StepBack+DSC auf GSM8K: 5,2-mal weniger Tokens als SC@32 bei +0,9 Punkten. Zusatzanalysen: 1,5B-PRM reicht weitgehend (+0,36 Punkte, -23,8 % Tokens im 8-mal-4-Setting); draft-lastige Budgets robuster, suffix-lastige sparsamer; bei 4-mal-8 liegt PRM-Lokalisierung 2,06 Punkte über Final-Step-Rollback. Limitationen der Autoren: nur zwei Signale, nur Mathe und Multi-Hop-QA, kleine Modelle; auf AIME24/OlympiadBench instabil, weil frühe Denkfehler lokales Resampling überstehen.
Quellen
- DRAFT-Bench: Evaluating Frontier Agents Across the Professional Design Lifecycle, arXiv (University of Maryland / Curify) (abgerufen 2026-11-09)
- DRAFT-Bench: Aufgaben und Toolkit, GitHub / super-inbox (abgerufen 2026-11-09)
- Frontier3DBench: Benchmarking Coding Agents for 3D Creation across Objects, Scenes, and Interactive Open Worlds, arXiv (Einsia.AI / Tsinghua University) (abgerufen 2026-11-09)
- StepBack: Step-Level Error-Localized Resampling for Efficient Test-Time Reasoning, arXiv (North Carolina State University) (abgerufen 2026-11-09)