 KI
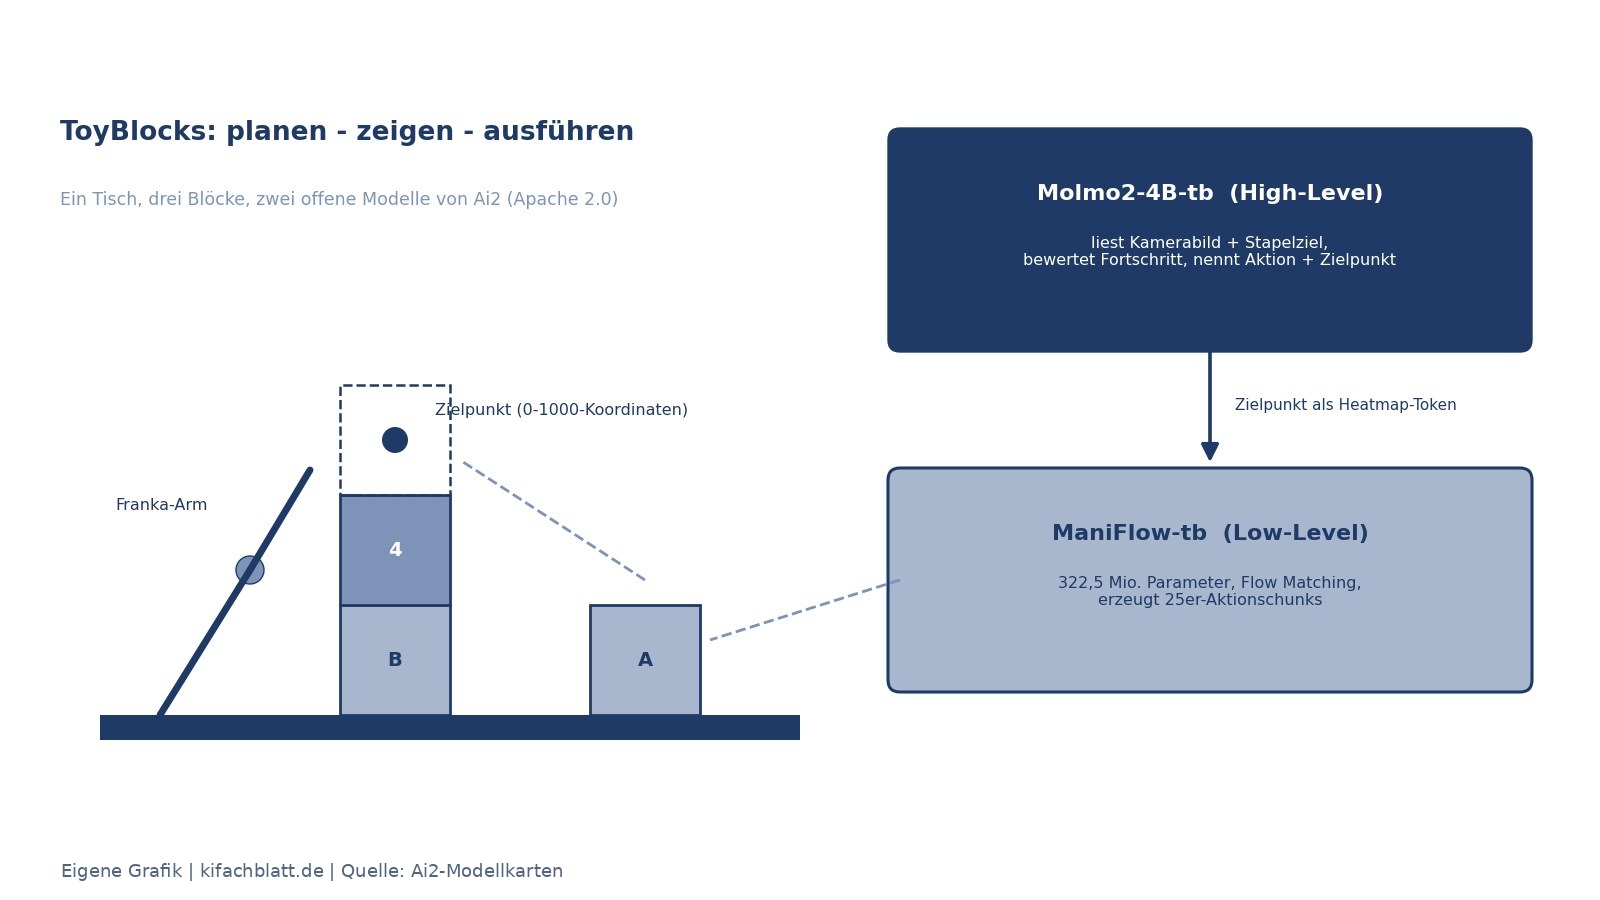
Das Allen Institute for AI (Ai2) hat ToyBlocks veröffentlicht, einen bewusst minimal gehaltenen, offenen Versuchsstand für Roboter-Grundmodelle: ein Tisch, drei Blöcke, ein Franka-Arm [1][2]. Zwei Modelle teilen sich das Stapeln - ein Vision-Language-Modell plant und zeigt auf das Ziel, eine kleine Fluss-Policy führt die Bewegung aus. Gewichte, Code und Trainingsdaten sind offen, und die Modellkarten dokumentieren Testaufbau und Grenzen.
Die Eckdaten
ToyBlocks im Überblick (Herstellerangaben aus den Modellkarten) [1][2]
Systemaufbau
Zwei Modelle: Molmo2-4B-tb (High-Level, ca. 4,5 Mrd. Parameter, rund 6 Hz, etwa 20 GB GPU-Speicher in BF16) plant; ManiFlow-tb (Low-Level, 322,5 Mio. Parameter) führt aus [1][2]
High-Level-Modell
Feinabstimmung von Molmo2-4B: SigLIP-2-so400m/14-Bildencoder (378 px, 27 Schichten) plus Qwen3-4B als Sprachmodell (36 Schichten, 32 Abfrage- und 8 KV-Köpfe, Grouped-Query-Attention). Eingabe: ein 640x360-Kamerabild und ein Textziel. Ausgabe: Fortschritt des Ziels, nächste Aktion (pick, place, flip, rotate, done) und ein Zielpunkt in 0-bis-1000-Koordinaten [1]
Low-Level-Modell
DiTX-Aktionskopf (12 Schichten, 8 Köpfe, Breite 768) mit Flow Matching und Konsistenztraining, 12 Integrationsschritte bei der Inferenz. Eingaben: Front- und Greiferkamera (224x224, CLIP ViT-B/16), 9-dim Roboterzustand, Aufgabenname (T5-small) und ein Ziel-Heatmap-Token des High-Level-Modells. Ausgabe: Aktionschunks von 25 Schritten (Vorhersagehorizont 50) [2]
Training
High-Level: 6.000 Schritte bei Batch 256 auf simulierten Drei-Block-Episoden, gemischt mit 25 Prozent allgemeinen Zeige-Daten (PixMo-Points, PixMo-Count, CoSyn-Point), damit die Zeigefähigkeit erhalten bleibt. Low-Level: 200.000 Schritte auf 8 GPUs, AdamW, Cosine-Schedule [1][2]
Kosten und Umwelt
Rund acht Stunden auf einem Knoten mit acht H100-GPUs für das High-Level-Modell. Die Karte rechnet mit ihren Annahmen (8 kW, PUE 1,2, 0,4 kg CO2e pro kWh) auf 30,7 kg CO2e und verdoppelt diesen Wert auf rund 61 kg pro Lauf [1]
Lizenz
Apache 2.0 für Gewichte und Code beider Modelle [1][2][3]. Einschränkung: Das Basismodell Molmo2-4B wurde auf Drittdatensätzen trainiert, die nur akademische und nichtkommerzielle Forschungsnutzung erlauben; die Karte rät ausdrücklich, das vor produktivem Einsatz zu prüfen [1]
Verfügbarkeit
Die Hugging-Face-Repositories wurden laut Plattform-API am 5. November 2026 angelegt und sind nicht zugangsbeschränkt; die Code-Repositories github.com/allenai/toyblocks und github.com/allenai/maniflow-tb stehen unter Apache 2.0 [1][2][3]. Der in den Karten verlinkte Blogbeitrag und der als Entwurf zitierte Technikbericht konnten bei unserem Abruf nicht gelesen werden.
Wie das Zusammenspiel funktioniert
Das Ziel nennt den Turm von oben nach unten: 'stack A 4 B. plan. point to target. predict action.' Das High-Level-Modell antwortet mit Lage, nächstem Schritt und Zielpunkt, etwa 'now: A not on 4, 4 on B. next: move A to 4. Do: block A <points> pick' [1]. Der Zielpunkt liegt fünf Pixel unter der Blockmitte, damit er auf die der Kamera zugewandte Fläche zeigt; optional kann die vorherige Aktion vorangestellt werden. Das Low-Level-Modell bekommt diesen Punkt als Heatmap-Token und erzeugt die Arm-Bewegung; eine eigene Aktionsdimension (1 = ausführen, 0 = pausieren, -1 = fertig) muss bei den Werten 1 und 0 zurückgeführt werden [2].
Die gemeldeten Messwerte
In der Simulation gibt es drei Teststände mit je exakt 200 Episoden: Leicht (stapeln), Mittel (umdrehen und stapeln), Schwer (suchen, umdrehen, stapeln). Mit einem klassischen Bewegungsplaner als Low-Level erreicht das VLM bei gesehenen Blöcken 97,5/53,5/31,5 Prozent, mit ungesehenen 81,0/36,5/14,5 Prozent. Mit ManiFlow als Low-Level: 55,5/35,5/17,0 Prozent (gesehen) und 44,5/12,5/10,0 Prozent (ungesehen) [1]. Auf einem echten Roboter gelangen mit ManiFlow 60 Prozent von zehn Versuchen [1].
- VLM + Bewegungsplaner
- VLM + ManiFlow
Daten als Tabelle
| VLM + Bewegungsplaner | VLM + ManiFlow | |
|---|---|---|
| Leicht (gesehene Blöcke) | 97,5 | 55,5 |
| Mittel (gesehene Blöcke) | 53,5 | 35,5 |
| Schwer (gesehene Blöcke) | 31,5 | 17 |
Anbieterangaben aus den Modellkarten, je Teststand exakt 200 Episoden, von uns nicht unabhängig nachgemessen [1]. 'Gesehen' heißt: Blöcke aus dem Training in neuen Konfigurationen; die Werte für ungesehene Blöcke liegen deutlich darunter (im Text).
ManiFlow allein, mit aufgezeichnetem Plan als High-Level (Oracle), liegt in vier Läufen à 128 Episoden bei 54 bis 59 Prozent [2]. Zwei Details zeigen, wie genau hier gemessen wird: Das Standard-Zeitlimit von 30 Sekunden lässt nur 26 bis 28 von 128 Episoden erfolgreich enden - laut Karte misst das eher das Limit als das Modell, die Auswertung nutzt daher das Dreifache der längsten Expertendemonstration (hier 194 Sekunden). Und die Simulation ist nicht bitgenau deterministisch: Dieselbe Episode kann zwischen zwei Läufen zwischen Erfolg und Misserfolg kippen, zwei Läufe stimmen nur in 82 bis 97 der 128 Episoden überein [2].
Ehrliche Grenzen
Der Geltungsbereich ist bewusst eng: Blöcke auf einem Tisch bewegen, alles andere ist laut Karte außerhalb des Einsatzbereichs; Sicherheitsbenchmarks wurden nicht angepasst, weil sie für ToyBlocks-Aufgaben als nicht relevant eingestuft werden [1]. Der Leistungsabfall bei ungesehenen Blöcken ist deutlich (im Schwer-Stand von 31,5 auf 14,5 Prozent mit Planer) [1]. Und das High-Level-Gewicht liegt als Float32-Datei im nativen Molmo2-Format vor, nicht als Transformers-Modell - die Inferenz läuft über den ToyBlocks-Code [1].
Reproduzierbarkeit
Die Karten beschreiben die ausgelieferten Dateien: Beim High-Level-Modell liegen Gewichte (model.pt) und die komplette Konfiguration (config.yaml), beim Low-Level-Modell Gewichte als Safetensors, Konfiguration und Normalisierungsstatistik der Trainingsdaten (stats.json) [1][2]. Auswertung und Training laufen über die offenen Skripte der Code-Repositories; der Trainingsdatensatz ist als allenai/toyblocks-data verlinkt [2][3].
Einordnung
ToyBlocks ist kein Leistungsrekord, sondern Infrastruktur: ein kompletter, kleiner Stack - VLM, Policy, Daten, Code -, an dem sich Ideen für Roboter-Grundmodelle gegenseitig vergleichbar prüfen lassen. Bemerkenswert ist die Dokumentationskultur: Zeitlimit-Effekte, Lauf-zu-Lauf-Varianz und die Lizenzfalle in den Trainingsdaten stehen in den Karten, nicht im Kleingedruckten. Wer damit kommerziell arbeiten will, muss vor allem die Drittdatensätze des Basismodells prüfen; wer forscht, bekommt einen Versuchsstand mit ausdrücklich dokumentierten Fehlversuchen.
Methode
Analyse auf Basis der vollständig gelesenen Hugging-Face-Modellkarten beider Modelle, der Hugging-Face-Repository-API (Anlagedaten, Dateilisten) und der geöffneten GitHub-Code-Repositories (Aufbau und Lizenzhinweise). Sämtliche Messwerte sind Herstellerangaben aus den Karten. Keine eigenen Tests.
Grenzen
Keine eigenen Tests. Der verlinkte Blogbeitrag und der als Entwurf zitierte Technikbericht konnten bei unserem Abruf nicht gelesen werden - Angaben über die Karten hinaus konnten wir nicht prüfen. Die Real-Roboter-Auswertung umfasst nur zehn Versuche. Die Simulationswerte sind laut Karte nicht bitgenau deterministisch (Lauf-zu-Lauf-Varianz im Text). Wir haben keine unabhängige Fremdmessung ausgewertet.
Quellen
- allenai/Molmo2-4B-tb (Modellkarte und Repository-API), Hugging Face / Ai2 (abgerufen 2026-11-06) ↩1 ↩2 ↩3 ↩4 ↩5 ↩6
- allenai/maniflow-tb (Modellkarte und Repository-API), Hugging Face / Ai2 (abgerufen 2026-11-06) ↩1 ↩2 ↩3 ↩4 ↩5 ↩6
- allenai/toyblocks und allenai/maniflow-tb (Code-Repositories, GitHub-API), GitHub / Ai2 (abgerufen 2026-11-06) ↩1 ↩2 ↩3
- allenai/maniflow-tb: ManiFlow-Code-Repository, GitHub / Ai2 (abgerufen 2026-11-06)