 KI
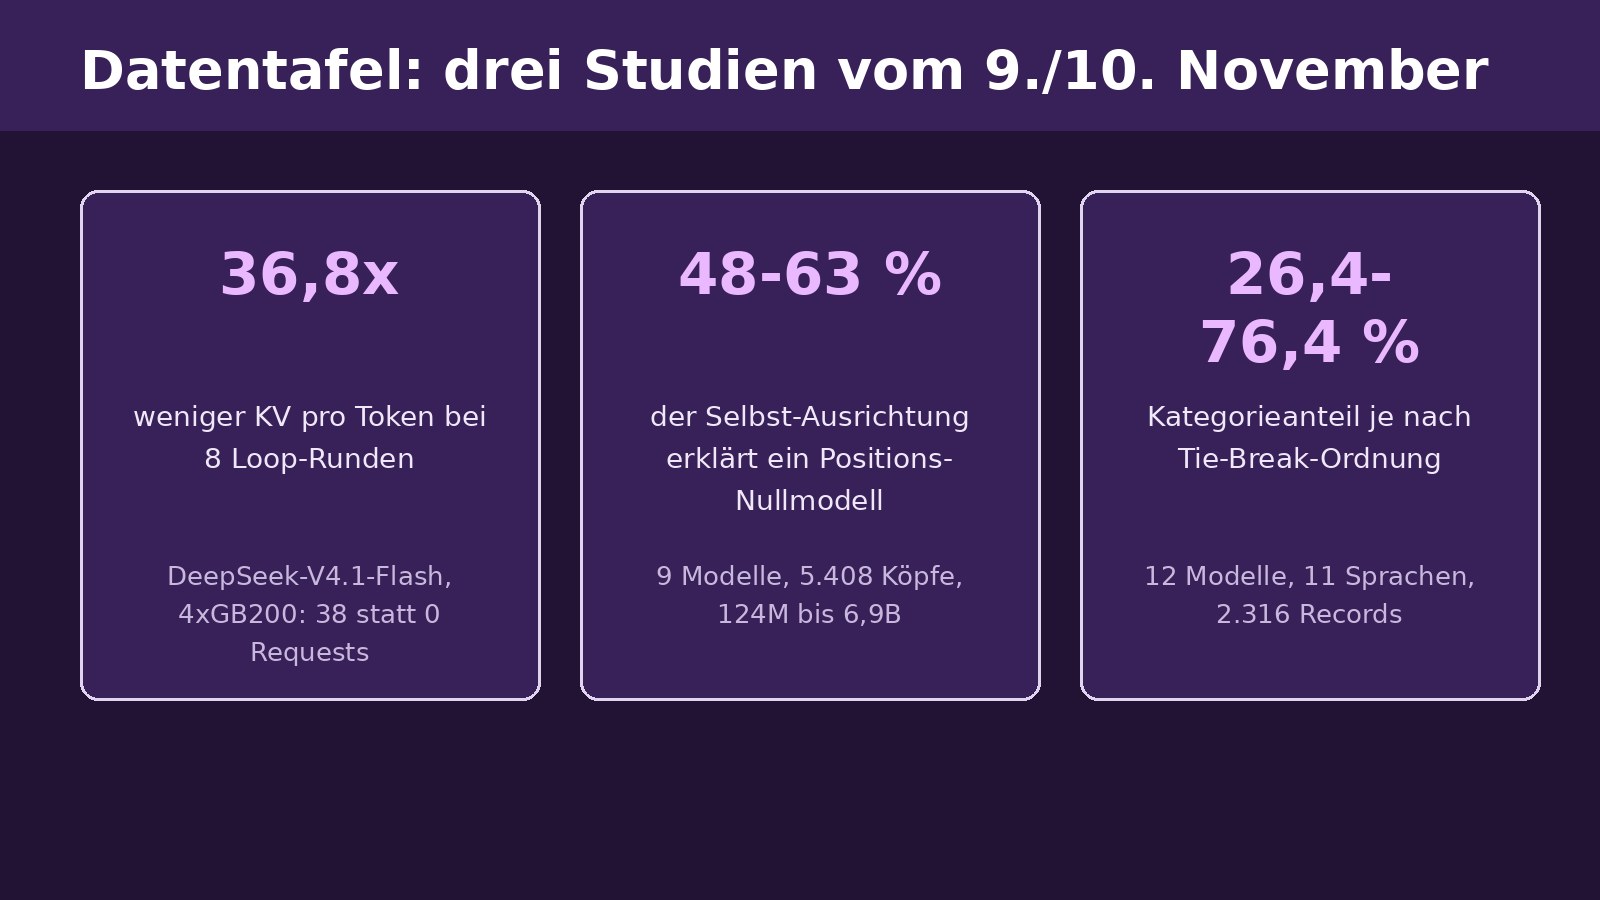
Fachüberblick vom 12. November, Quellenstand 10:00 Uhr MEZ. Drei Preprints: ein geloopter Causal Encoder-Decoder mit rundeninvariantem KV-Cache, ein dreiteiliger Prüfrahmen für Attention-Eingriffe und eine Reliabilitätsanalyse von Reasoning-Fehlertaxonomien. Die folgenden Zahlen sind Befunde der jeweiligen Autoren aus Preprints, keine von uns nachgemessenen Produktwerte.
1. Looped CED: Rekurrenz ohne KV-Wachstum
Leng, Zhang, Sun, Qian, Zhao und Zhang (UCSD, Tsinghua, Nanjing) loopen einen Causal Encoder-Decoder (CED), in dem nur wenige Encoder-Schichten globale KV erzeugen. Platzierung: Der Loop muss im Encoder sitzen, damit jede Runde die globale KV-Quelle verfeinert; der Decoder-Loop liest statische Projektionen erneut, ein reiner SWA-Loop zeigt schwächere Langkontext-Skalierung (Positions-BPB auf PG19, FinePDFs, GovReport). Training: Stochastische Rekurrenztiefe erzeugt einen kontraktiven Fixpunkt, sodass alle Runden die Last-Round-KV mit nahezu gleicher BPB in den kleinen Qualitätsmodellen teilen; ohne Konvergenz oszilliert der Zustand (31 Prozent Bewegung pro Runde). Ergebnis: BPB-Parität zum gelooppten Dense-Transformer innerhalb 0,001 auf allen drei Skalen (90M, 150M, 340M) bei einem Sechstel des globalen KV; 89, 86 und 93 Prozent des Dense-Loop-Gewinns; Über 29,6 Milliarden Trainingstoken bleibt die Parität stabil.
Serving-Kostentest der Autoren: DeepSeek-V4.1-Flash (552B) mit 8 Runden auf 4xGB200 (TP4), SGLang mit eigenem Plugin. KV pro Token 1,6 statt 60,0 KB (36,8x, davon 5,2x aus dem Runden-Sharing), Pool 5,11M Token (39x); 8K/1K 185,1 statt 50,9 tok/s/GPU (3,6x); 32K-Dekodierung 2,8x; 128K-Kontext 38 Requests statt OOM (16,5x bei T=4); mediane Multi-Turn-Agent-TTFT 11,6 statt 345,1 s (29,7x gegenüber CED mit Per-Round-KV bei 512 parallelen Sitzungen), weil der Prefix-Cache nicht mehr kollabiert. Gegenrechnung: T=8 erhöht die physischen Schichtdurchläufe um 4,15x und die Dekodierschritt-Latenz um 3,95x; gemessene GB200-Prefill-Steigung 5,12x gegenüber CED T=1 (Appendix I, Tabelle 13; 2,6-2,9x gehören zum Decoder-Loop); der Vorteil hängt von Workload, Kontextlänge und Parallelität ab. BPB-Parität ist nur bis 340M gezeigt; 8xH200-Test: Kapazität wie ungelooppt bis 1M Kontext, 3,5x schnellere Dekodierung bei 524K. Wichtig: Diese 552B-Tests verwenden Dummy- oder ursprüngliche Gewichte, die nicht zum Loopen trainiert wurden. Die Per-Round-KV-Basis wird bei gleichem Rechenaufwand über eine begrenzte KV-Pool-Größe emuliert. Gemessen werden Servingkosten, nicht Antwortqualität; verlustfreies Last-Round-Sharing wird auf 552B aus den kleinen Qualitätsmodellen angenommen. Das ist kein end-to-end trainiertes, qualitätsvalidiertes 552B-Produkt.
2. Sanity Checks für Attention Surgery
Basavaraj R M und Aryan Bharat Kumar formulieren drei wiederverwendbare Checks und wenden sie auf XSA an (Entfernung der Kopfkomponente entlang des eigenen Value-Vektors). Check 0, Resolvierbarkeit: Split-Half-Reliabilität des Eingriffseffekts 0,795 (GPT-2), 0,419 (Pythia-160M), 0,531 (Pythia-410M) bei Strukturreliabilität über 0,99; attenuierte Effekte dürfen nicht mit Strukturstatistiken korreliert interpretiert werden. Check 1, Anisotropie-Null: Über neun Multi-Head-Modelle (5.408 Köpfe, 124M bis 6,9B) erklärt ein Earlier-Position-Null 48 bis 63 Prozent der Head-Value-Kosinus-Ausrichtung, ohne monotone Skalentendenz (58,1 Prozent bei 6,9B); Selbst-Kosinus fällt von 0,483 (GPT-2) auf 0,340 (Pythia-6,9B). Bei drei GQA-Modellen ist die Ausrichtung eigene-Gruppe-spezifisch (plus 0,24 bis 0,27) mit negativem Überschuss gegenüber dem gruppenübergreifenden Nullmodell (minus 0,11 bis 0,19); kein Nachweis eines generell negativen rohen Kosinus.
Check 2, gematchte Intervention: Vorregistriertes 3-Arme-x-8-Seeds-Faktoriell, 400 Millionen Token pro Lauf, 50,9M Parameter. RANDOM (feste beliebige Rang-1-Richtung) plus 0,0011 nats zur Baseline (p = 0,197); XSA minus 0,0029 nats (Holm p = 0,0023); XSA gegen RANDOM minus 0,0040 nats (p = 0,0018). Der eigene-Value-Arm schlägt diese statische Kontrollrichtung, aber der Befund ist auf 50,9M beschränkt; große Kosinus-Ausrichtung allein belegt keine Redundanz in eingefrorenen Modellen, Pruning-Aussagen für produktive Systeme lehnen die Autoren ab. Reproduzierbarkeit: Code, Konfigurationen, Per-Head-Rohdaten und Validierungsskripte laut Paper auf GitHub und Zenodo; laut Autoren reproduziert ein Manifest 33 numerische Claims aus den archivierten Dateien; wir haben Checker und Experimente nicht ausgeführt; Messungen an zwölf Pretrained-Modellen mit Revisions-Hashes. Der Kontrollvergleich trennt Richtungswahl nicht vollständig von Projektionsstärke: XSA ist eingabeabhängig, die Kontrollrichtung statisch; eine pro Token wechselnde Kontrolle bleibt offen.
3. Fehlertaxonomie: Pluralität per Tie-Break
Beesetty (PayPal) misst die selbst definierte Kategorie Compositional Collapse (bemerktes Strukturteil wird fallengelassen) auf MGSM-Symbolic (öffentlich): 12 Modelle, 11 Sprachen, 2.316 bewertete Records. 50,1 Prozent der Fehler tragen Belege für mehrere Kategorien; der Klassifikator vergibt ein Label per geordnetem Tie-Break. Zwei vertauschte Tests verschieben die Pluralität in 11 von 12 Modellen; über sechs wirksame Ordnungen reicht der Collapse-Anteil von 26,4 bis 76,4 Prozent und gewinnt in genau drei. Die Mehrfachbelegungsraten reichen von 10,9 Prozent (Claude Sonnet 5) bis 72,3 Prozent (Neural-Chat-7b); das sind nicht die Collapse-Einzelraten.
Reliabilität: Bei der Antwortkorrektheit einigen sich Inspector und Muttersprachler mit Kappa 0,932, die Kategorie mit 0,093; zweite Muttersprachler pro Sprache (142 Items, 121 determinate Paare) erreichen untereinander Kappa 0,659, gegen den Inspector höchstens 0,094. Derselbe Inspector (Claude Sonnet 5) mit dem Human-Prompt wortwörtlich: Kappa 0,636 statt 0,147 gegen Human 2 auf denselben 106 bestimmt gelabelten Paaren; die Diskrepanz ist promptbedingt. Benchmark-Defekt: In einer Zwei-Aufgaben-Runde fehlt in den bengalischen und chinesischen Übersetzungen eine tragende Klausel (Frage und Referenz unvereinbar); im stratifizierten Prüfsample, nicht als Korpusschätzung, fällt das Ratenverhältnis außerhalb dieser Runde von 1,81x auf 1,17x, gemeldet an die Maintainer. Limitationen: zwölf konfundiert gepanelte Modelle, acht Aufgabenstrukturen Grundschulmathematik, eine Kategorie, ein Inspector; die Übertragbarkeit auf andere Taxonomien ist Hypothese. Empfehlung: Mehrfachbelegung berichten, Tie-Break permutieren, auf geteilter Stichprobe validieren, systematische Differenzen auditieren. Diese Übereinstimmung belegt Reproduzierbarkeit unter den jeweiligen Anweisungen, nicht die Wahrheit eines Labels. Ein unabhängiger Ground-Truth-Rater fehlt, und Menschen teilen Definition und Beispiel.
Quellen
- Looping Deeper Without Growing the KV Cache: Recurrent Depth for Causal Encoder-Decoders, arXiv (Jiaqi Leng, Minshen Zhang, Zhaofeng Sun, Yu-Yang Qian, Peng Zhao, Hao Zhang; UC San Diego, Tsinghua, Nanjing) (abgerufen 2026-11-12)
- Sanity Checks for Attention Surgery: Null Models and Matched Interventions for Representation-Motivated Design, arXiv (Basavaraj R M, Aryan Bharat Kumar) (abgerufen 2026-11-12)
- Agreeing on the Answer but Not the Reason: Measurement Limits of LLM Reasoning Failure Taxonomies, arXiv (Madhu Sudhan Rao Beesetty, PayPal) (abgerufen 2026-11-12)