 KI
Fachüberblick am Abend, 31. Oktober 2026. Quellenstand: 16:05 Uhr MEZ. Drei Meldungen der vergangenen Tage, die jeweils eine Architekturentscheidung betreffen: Apple definiert, auf welche Datenklassen ein Assistent zugreifen darf - und wo er das nicht tun wird. Fujifilm rechnet vor, dass die kälteste Speicherschicht wieder wächst. Und zwei Publikationen zeigen, wie natürlichsprachliche Interfaces in die Protein- und Genomwerkzeuge einziehen. Dieser Überblick ergänzt die einzelnen Tagesartikel.
1. Apple iOS 27.2: Gedächtnis mit Scoping
Siri erhält mit iOS 27.2 und macOS Golden Gate 27.2 ein Gedächtnis über Konversationen hinweg: Der Assistent kann auf frühere Anfragen Bezug nehmen. Neu ist die Breite der Datenquellen - Voicemails, Anhänge aus Nachrichten und das Safari-Verhalten kommen hinzu. Relevant für die Einordnung ist das Gegenstück: Mit "Excluded Apps" lässt sich der Zugriff pro App sperren. Apple baut die Einwilligung also als App-Liste, nicht als Global-Schalter. Dazu kommen fünf neue Sprachen, darunter Französisch, Japanisch und Koreanisch. Die Spracherweiterung umfasst Französisch, Japanisch, Koreanisch, Portugiesisch und Spanisch; Deutsch ist nicht darunter. Für deutschsprachige Nutzer ändert sich damit doppelt nichts: keine neuen Siri-KI-Funktionen in der EU und keine deutsche Sprachunterstützung in der neuen Siri.
Marktseitig ist die wichtigste Zeile in den Release-Notes: Die Siri-KI-Funktionen sind in der EU und auf dem chinesischen Festland nicht verfügbar. Apple begründet das in den Notes nicht; ein EU-Termin fehlt. Aussagen über Gründe wären Spekulation. Unabhängig davon bringt 27.2 zwei bemerkenswerte Einzelfunktionen: Fotos versieht KI-generierte Bilder mit SynthID-Wasserzeichen - ein Provenienz-Signal, das sich in anderen Apple-Systemen maschinell prüfen lässt - und Nachrichten generiert Antwortvorschläge aus dem Gesprächskontext. Ergänzend kommen präzisere Textmarkierung und Apple-TV-Profile pro Person; beides ist eher Produktpflege als Architektur.
2. Fujifilm: Tape als air-gapped Archivschicht
Fujifilm verfünffacht die Produktionskapazität für LTO-Ultrium-10-Medien gegenüber dem Geschäftsjahr 2025, Standort Odawara, Zeitraum Geschäftsjahre 2026 bis 2028. Die Begründung des Herstellers: Archivierungsbedarf für Datenbestände generativer KI. Technologisch setzt Fujifilm auf hybride Magnetpartikel aus Bariumferrit und Strontium. Das LTO-Konsortium projiziert in seiner Roadmap die Generationen 11 bis 14; das ist eine Konsortial-Projektion, keine Lieferzusage. Aktueller Standard am Markt ist die zehnte LTO-Generation; die höheren Generationen existieren bislang nur als Roadmap.
Architektonisch ist die Logik bekannt, aber aktuell gefragt: Tape lagert offline (Air Gap) und ist damit gegen Ransomware immun, solange die Kassette im Regal steht. Für Datenschichten heißt das: Hot-Storage für aktive Workloads, Tape als kalte, manipulationssichere Kopie dahinter. Wer Datenhaltung plant, sollte die Schicht bewusst einrechnen - die Kapazitätsankündigung zeigt, dass die Herstellerseite mit anhaltender Nachfrage rechnet. Hinzu kommt die Betriebsseite: Bandarchive brauchen klare Ausleih- und Wiederanlaufprozesse, sonst bleibt die kalte Schicht im Ernstfall kalt und unerreichbar.
3. Pinal: Text-zu-Struktur in zwei Stufen
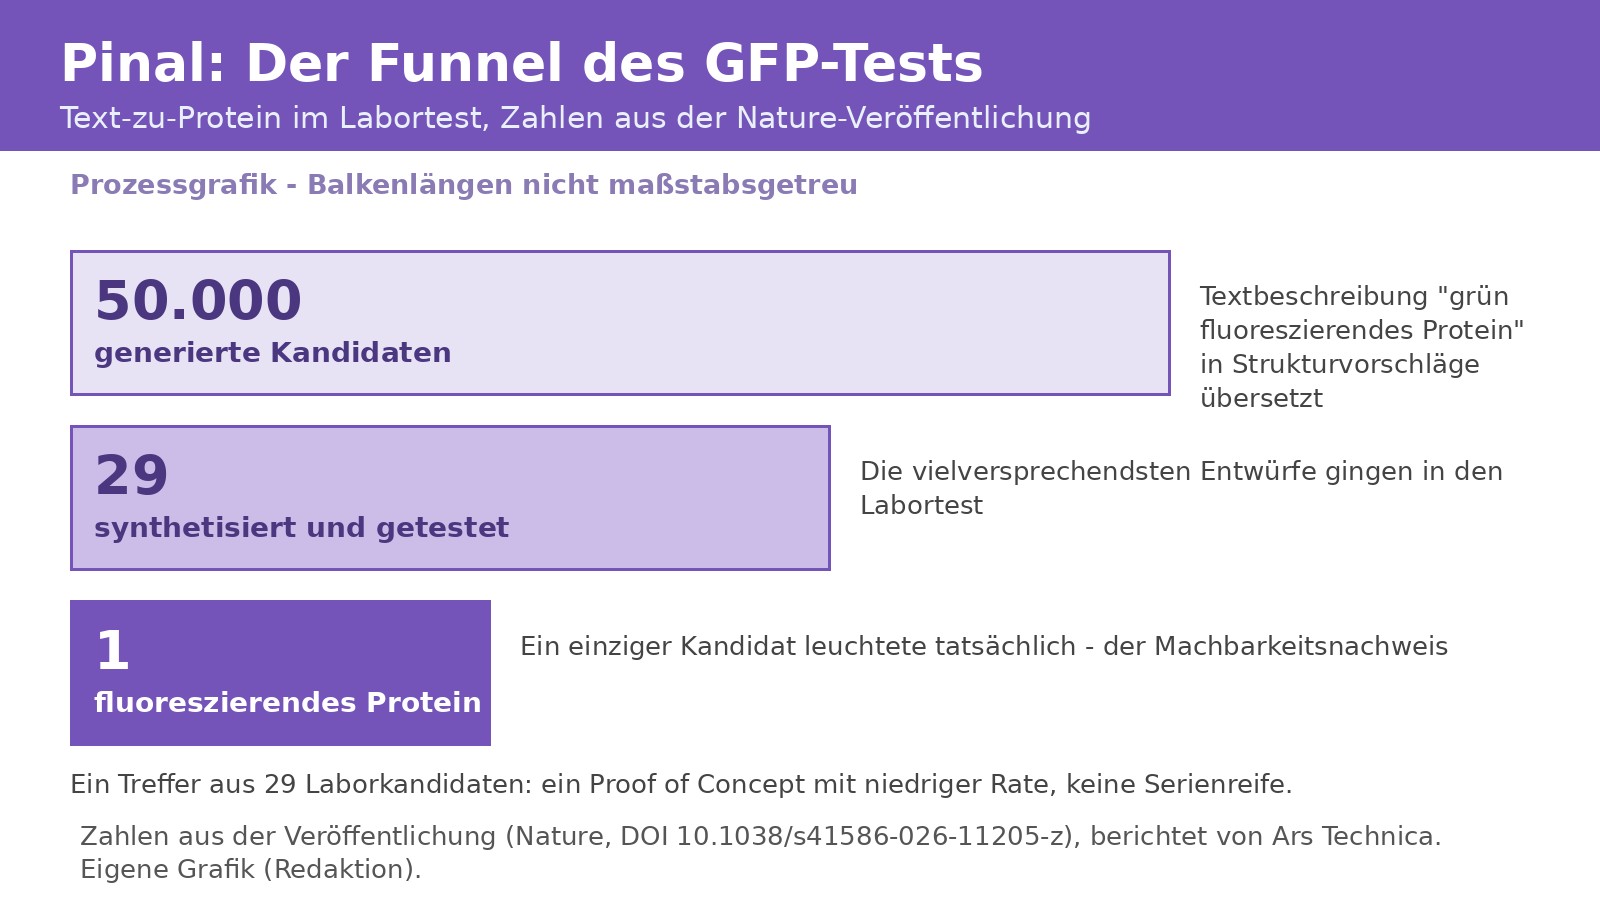
Pinal (Nature, DOI 10.1038/s41586-026-11205-z) übersetzt natürlichsprachliche Beschreibungen in Proteindesigns. Die Architektur ist zweistufig: T2struct wandelt die Beschreibung zunächst in einen Strukturplan um; SAProt-T wertet Text und Plan gemeinsam aus und erzeugt daraus die Aminosäuresequenz des Entwurfs. Trainiert wurde mit Proteinsequenzen aus drei Datenbanken plus per AlphaFold vorhergesagter Strukturen - allein eine der Datenbanken steuerte 800 Millionen Stichwort-Protein-Paare bei. Im dokumentierten GFP-Test wurden 50.000 Kandidaten erzeugt, 29 im Labor synthetisiert und getestet, eines fluoreszierte. Diese Quote ist kein Skandal, sondern der ehrliche Kern der Arbeit: ein Proof of Concept mit dokumentierter, niedriger Trefferrate - belastbarer als viele Demo-Claims. Der Trainingskorpus kombiniert Kuratierung und Vorhersage: Neben den annotierten Paaren aus drei Datenbanken flossen per AlphaFold vorhergesagte Strukturen ein, was die Abdeckung erhöht, aber Modellunsicherheit in die Trainingsdaten holt.
4. Carbon X: DNA-Sprachmodell für lokale Auswertung
Carbon X - entwickelt von Hugging Face, dem Zhongguancun-Institut und der Universität Neapel - mid-traint Qwen3-14B auf DNA-Sequenzen und veröffentlicht die Gewichte offen. Das Modell läuft lokal, etwa auf einem MacBook: Genomdaten müssen die eigene Infrastruktur nicht verlassen, was bei Erbgutdaten ein Datenschutzvorteil ist. Die vom Team berichtete Vergleichbarkeit mit GPT-6.1 Sol stammt aus internen, unveröffentlichten Tests und ist als Anbieterangabe zu werten; eine unabhängige Evaluation liegt bisher nicht vor. Das Team selbst benennt Schwächen: Exakte Positionsangaben sind unzuverlässig, Halluzinationen bleiben ein Risiko. Für den Einsatz heißt das: geeignet als exploratives Werkzeug, nicht als ungeprüfte Befundquelle. Technisch ist Carbon X kein von Grund auf trainiertes Genommodell, sondern ein Mid-Training: Ein bestehendes Sprachmodell (Qwen3-14B) wird auf Sequenzdaten weitertrainiert und übernimmt dabei die Sprachfähigkeit des Basismodells in die Genomdomäne.
Quellen
- Apple releases iOS and macOS 27.2 with new Siri AI features, new Music logo, Ars Technica (abgerufen 2026-10-31)
- Fujifilm to boost tape production 5x as AI fuels archiving demand, Ars Technica (abgerufen 2026-10-31)
- "Vibe genes": Naturalish language comes to protein, genome design software, Ars Technica (abgerufen 2026-10-31)