 KI
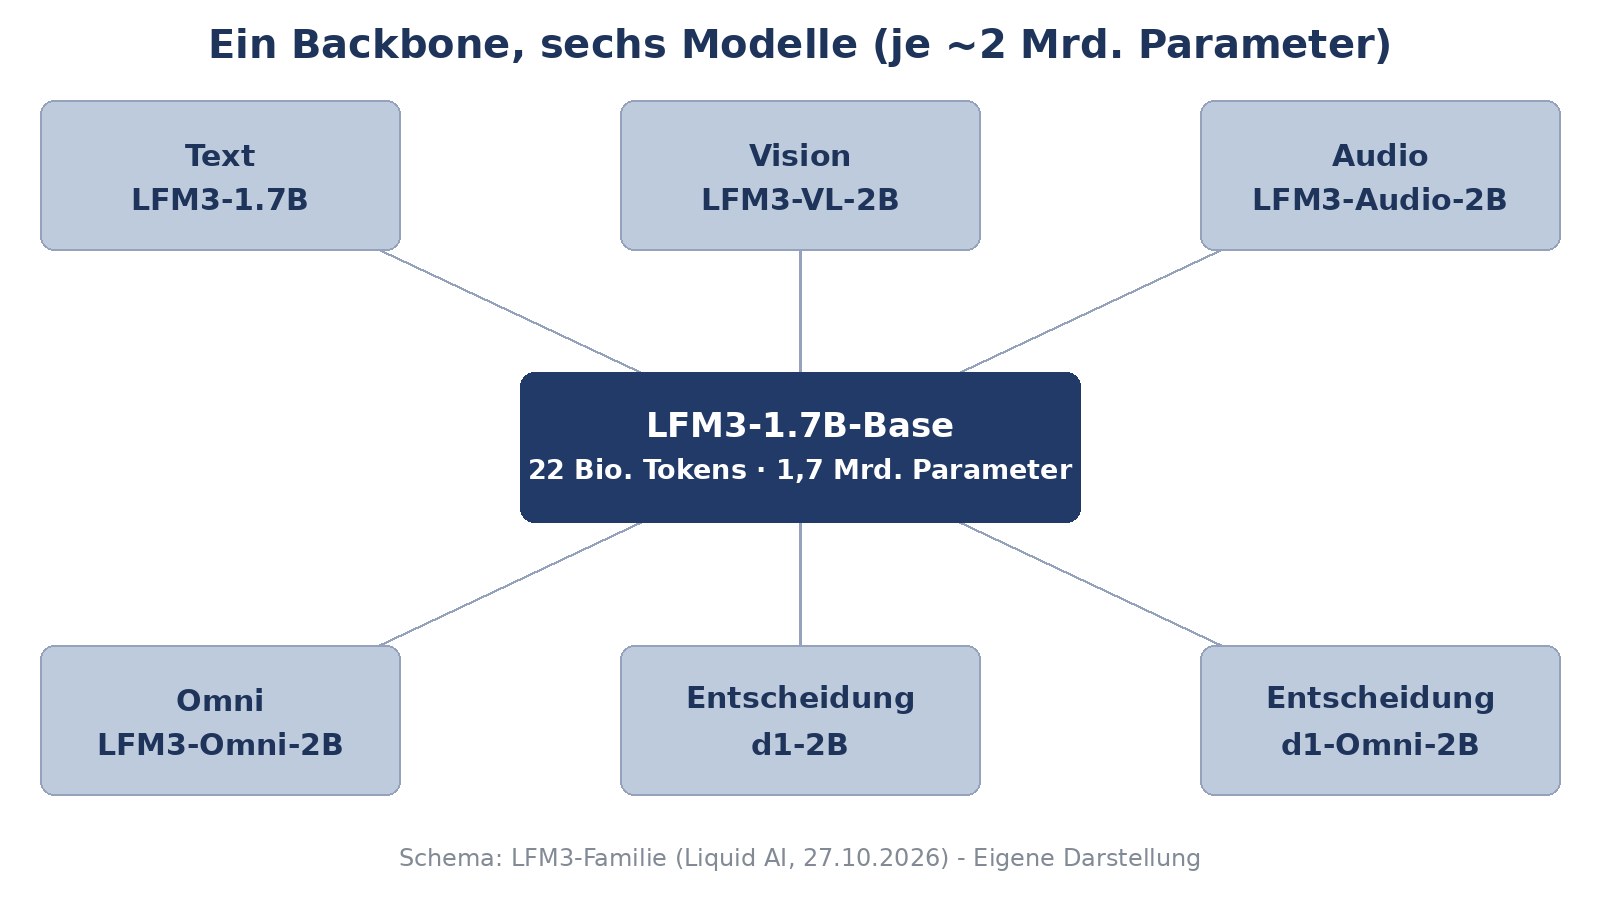
Liquid AI hat am 27. Oktober 2026 LFM3 vorgestellt, die neue Generation seiner Liquid Foundation Models. Der Ansatz bleibt der gleiche wie beim Vorgänger LFM2 - kleine, effiziente Modelle für Geräte statt Cloud -, aber die Familie ist jetzt explizit multimodal: Sechs Modelle rund um 2 Milliarden Parameter decken Text, Bild, Audio, eine Omni-Variante und zwei Entscheidungsmodelle ab, alle vom selben Backbone abgezweigt [1][2].
| Modell und Zweck | Eingabe | Ausgabe | Basis |
|---|---|---|---|
| LFM3-1.7B - Textmodell für lokale Agenten, Werkzeugaufrufe und Fine-Tuning | Text | Text | LFM3-1.7B-Base |
| LFM3-VL-2B - visuelles Verstehen, erstmals auch mit Video-Eingabe | Text, Bild, Video | Text | Backbone + Vision-Enc. |
| LFM3-Audio-2B - Sprachchat, Transkription und Audio-Verstehen in 18 Sprachen | Text, Audio | Text, Sprache | Backbone + LiquidCodec |
| LFM3-Omni-2B - sieht, hört und antwortet in einem Modell | Text, Bild, Video, Audio | Text, Sprache | Backbone + Enc./Dec. |
| d1-2B - Entscheidungsmodell: beantwortet Fragenlisten in einem einzigen Forward-Pass | Text, Bild, Video | Kalibrierte Antworten | LFM3-VL-2B |
| d1-Omni-2B - dasselbe, zusätzlich mit Audio-Eingabe | Text, Bild, Video, Audio | Kalibrierte Antworten | LFM3-Omni-2B |
Alle Gewichte stehen ab sofort auf Hugging Face, im Playground und über die Liquid AI API bereit - unter der LFM Open License v1.0 [1][3]. Kommerzielle Nutzung deckt die Lizenz nur bis zu einem Jahresumsatz von 10 Millionen US-Dollar ab [3]. Native Unterstützung gibt es für llama.cpp, MLX, vLLM, SGLang, ONNX und GGUF; Launch-Partner sind unter anderem AMD, Intel (OpenVINO), NVIDIA, Qualcomm und OpenRouter [1].
Architektur: Tri-Hybrid mit 24 Schichten
Das Rückgrat ist LFM3-1.7B-Base mit 1,73 Milliarden Parametern und 24 Schichten: 13 gated Short Convolutions (Kernelgröße 7 statt 3 wie bei LFM2), 5 Sliding-Window-Attention-Schichten mit 256-Token-Fenster und 6 Global-Attention-Schichten [1][3]. Dazu kommen Head-wise Gating (eine Sigmoid-Gate kann einzelne Köpfe abschalten, was laut Liquid die Quantisierung entlastet), Partial RoPE auf den Global-Attention-Schichten und eine Sandwich-Norm vor und nach jedem Block [1][2].
Die Architektur stammt aus Liquids Hardware-in-the-Loop-Suche, die jetzt 14 Geräte- und Backend-Kombinationen umfasst - vom Samsung Galaxy S26 Ultra über einen Raspberry Pi 5 bis zu Apple M4 Max, AMD Ryzen AI, Cloud-CPUs, GPUs und Qualcomms Hexagon-NPU [1][2]. Das Ergebnis: Pro Parameter erreicht LFM3-1.7B auf kurzen Prompts LFM2-1.2B-Niveau, bei 8K Tokens Kontext ist es rund 25 Prozent schneller [1]. Ein voller 128K-Kontext belegt nach Herstellerangabe 1,6 GB KV-Cache - zum Vergleich: 4,3 GB bei Qwen3.5-4B und 5,6 GB bei MiniCPM5-2B [1].
Trainiert wurde das Basismodell auf 22 Billionen Tokens; die letzten 3,5 Billionen bilden eine Mid-Training-Phase mit kuratierten Daten, mehr Agenten-Spuren und Werkzeugaufrufen, die auch das Kontextfenster auf 256K Tokens erweitert [1][2]. Das Vokabular von 128.000 Tokens teilt sich das Modell mit LFM2.5-8B-A1B [1][3].
Benchmarks: deutliche Sprünge, Herstellerangaben
Liquids eigene Messungen zeigen vor allem bei Agenten-Aufgaben große Sprünge gegenüber dem Vorgänger: Auf WebArena-Verified erreicht LFM3-1.7B 38,42 Punkte gegenüber 3,02 (LFM2.5-2.6B) und liegt damit auch vor Qwen3.5-9B (28,94); bei BFCL V4 (Werkzeugaufrufen) stehen 71,39 Punkte, auf ToolSandbox 80,36 [1]. Im Schnitt über Liquids Benchmark-Tabelle erreicht das 1,7B-Modell 49,37 Punkte, Qwen3.5-9B 47,24 [1].
- LFM3-1.7B
- LFM2.5-2.6B
- Qwen3.5-9B
- Gemma 4 E4B
Daten als Tabelle
| LFM3-1.7B | LFM2.5-2.6B | Qwen3.5-9B | Gemma 4 E4B | |
|---|---|---|---|---|
| WA-Verified | 38,42 | 3,02 | 28,94 | 17,06 |
| AutomationB. | 41,29 | 0,94 | 15,1 | 1,92 |
Zwei Agenten-Benchmarks aus Liquids Tabelle - Herstellerangaben, eigene Harness-Konfigurationen, nicht unabhängig verifiziert [1].
Wichtig ist die Einordnung: Alle Werte stammen aus Liquids eigener Tabelle mit herstellereigenen Harness-Konfigurationen (OpenClaw, OpenCode). Größere Modelle gewinnen laut Liquid weiterhin bei agentischem Coding und Wissensfragen; die eigene Modellkarte räumt ein, dass LFM3-1.7B für agentisches Coding und komplexes mehrstufiges Reasoning aufgrund der Größe 'nicht empfohlen' wird [1][3]. Der Praxisbericht eines externen Testers fällt positiv aus: MacPaw maß auf 65 Alltags-Agentenaufgaben unter macOS 64 Prozent Erfolg für LFM3-1.7B gegenüber 48 Prozent für Qwen3.5-2B, bei 58 Prozent weniger Tokens pro Aufgabe [1].
Das Post-Training lief in vier Stufen: 1,75 Billionen Tokens überwachtes Fine-Tuning, gemischtes Reinforcement Learning mit Längenstrafe, Multi-Domain On-Policy Distillation von sechs RL-Speziallehrern und zuletzt agentisches RL in echten Harness-Umgebungen [1].
Vision, Audio, Omni - und die Entscheidungsmodelle
LFM3-VL-2B ist das erste Vision-Modell der Reihe mit Video-Eingabe und liefert laut Liquid im Schnitt über 62 Vision-Benchmarks 71,4 Punkte (Vorgänger: 57,6) - auf Höhe von Gemma 4 12B (71,7) und zwei Punkte hinter GPT-5.6 Luna (73,4) [1][2]. Der neue hauseigene Vision-Encoder (164M Parameter) soll bei gleicher Genauigkeit 2,2-mal weniger Rechenleistung brauchen als Qwen3.5-2Bs Encoder [1].
LFM3-Audio-2B verarbeitet live Mikrofon-Eingang mit einer Time-to-First-Token von bis zu 50 Millisekunden; der neue Audio-Tokenizer LiquidCodec wandelt Tokens mit etwa 87-facher Echtzeitgeschwindigkeit auf einem einzelnen CPU-Thread in Sprache um [1]. LFM3-Omni-2B kombiniert beides zu einem Modell, das Bilder sieht, Sprache hört und gesprochen antwortet - in Liquids Omni-Tabelle führt es die 2B-Klasse etwa bei Video-plus-Audio-Verstehen (Daily-Omni 70,1) an [1].
Neu sind die Entscheidungsmodelle d1-2B und d1-Omni-2B: Sie beantworten eine Liste von Fragen zu einem Input in einem einzigen Forward-Pass, jeweils mit kalibrierter Wahrscheinlichkeit - neu mit typisierten Antworten wie Markieren im Bild, Extrahieren von Textstellen oder Schätzen mit Wertebereich. d1-2B ersetzt d1-3B bei einem Drittel weniger Parametern und besseren Werten [1].
Spezialisierung als Kernidee
Liquid positioniert LFM3 als Ausgangspunkt für 'spezialisierte Intelligenz': Jedes Modell lässt sich auf einer einzelnen GPU feintunen. Zwei Beispiele aus dem Blog: Ein paar Stunden Fine-Tuning auf rund 3.000 Drohnenfotos machten aus LFM3-VL-2B ein Inspektionsmodell für Windkraft-Schäden (Klassifikationsgenauigkeit von unter 10 auf 67 Prozent, Herstellerdemo); und ein 170-GPU-Stunden-Training verwandelte es in ein Vision-Language-Action-Modell mit 96,2 Prozent Erfolg auf den vier LIBERO-Suiten [1]. Ob sich das in fremden Händen reproduzieren lässt, wird die Praxis zeigen müssen.
Methode
Analyse auf Basis des Liquid-AI-Blogposts, des Hugging-Face-Blogposts und der offiziellen LFM3-1.7B-Modellkarte; alle drei Quellen wurden vollständig gelesen. Sämtliche Benchmark- und Latenzangaben sind Herstellerangaben in herstellereigenen Harness-Konfigurationen; die Modelle wurden von der Redaktion nicht selbst ausgeführt.
Grenzen
Keine unabhängige Verifikation der Benchmarks; Vergleichswerte zu Qwen, Gemma, MiniCPM und GPT-5.6 Luna stammen aus Liquids eigener Tabelle. Die Modellkarte räumt selbst ein, dass LFM3-1.7B für agentisches Coding und komplexes mehrstufiges Reasoning nicht empfohlen wird [3].
Quellen
- Introducing LFM3: Every Modality for Specialized Intelligence, Liquid AI (abgerufen 2026-10-28) ↩1 ↩2 ↩3 ↩4 ↩5 ↩6
- Build specialized multimodal models with LFM3, Hugging Face Blog / Liquid AI (abgerufen 2026-10-28) ↩1 ↩2 ↩3 ↩4 ↩5 ↩6
- LiquidAI/LFM3-1.7B - Modellkarte, Hugging Face / Liquid AI (abgerufen 2026-10-28) ↩1 ↩2 ↩3 ↩4 ↩5 ↩6