 KI
Mittagsüberblick vom 9. November 2026. Quellenstand: 09:52 Uhr MEZ. Drei Papers zur Evaluation von Coding-Agenten: kausale Interventionsmessung statt statischer Benchmarks, Judge-Kalibrierung aus Workflow-Outcome-Labels und ein Multi-step-Benchmark, in dem jeder Schritt auf dem eigenen Code des Agenten aufbaut. Die Befunde stammen aus Preprints; wir haben die Experimente nicht selbst wiederholt.
Kausale Interventionsmessung mit sequentieller Randomisierung
Die Stanford-Arbeit (arXiv:2611.09792) überträgt mikro-randomisierte Studien auf Agenten: An jedem eligiblem Entscheidungspunkt wird mit e(h) = 1/2 zwischen Eingriff und Kontrolle randomisiert. Drei Schätzziele: Blip-Effekt bei weiter randomisierter Fortsetzung (AIPW, bei bekannten Zuteilungswahrscheinlichkeiten modellfrei identifiziert), Blip ohne weitere Eingriffe sowie Policy-Gain gegenüber Niemals-Eingreifen (jeweils strukturell verschachtelte Mittelwertmodelle mit G-Schätzung und zusätzlichen Parametrikannahmen). Vorausgesetzt werden nur Black-Box-Zugriff und vier Standardannahmen; die Intervalle sind punktweise 95-Prozent-t-Intervalle ohne Mehrfachvergleichskorrektur.
Ergebnisse: In τ-bench Retail (Reviewer GPT 6 Luna, hoher Reasoning-Einsatz) sind die geschätzten Prüfeffekte für mehrere Auftragsgruppen positiv; bei Claude Haiku 5.5 liegt der Effekt über alle Reads nahe null, für account-details allein jedoch signifikant positiv - Aggregation verdeckt die Untergruppe. In ToolSandbox (33 Tools, 49 Gruppen) ist die Capability Zeit/Rechnen mit +1,8 [-0,2; 3,8] unentschlossen, das Einzeltool datetime-info-to-timestamp mit +6,9 [1,2; 12,6] nicht. In ImpossibleBench erhöht adversariales Feedback die Rate erkannter Regelverstöße (Qwen3.5 Flash): nach dem fünften Fehlversuch +9,4 Prozentpunkte [2,9; 15,9] gegenüber +3,3 [0,6; 6,1] nach dem ersten; bei ≥80 Prozent bestandenen Tests +5,7 [2,3; 9,2] gegenüber +0,3 [-1,7; 2,2] bei <50 Prozent. Neun selektive Review-Policies erreichten positive Gains; SNMM- und direkte Monte-Carlo-Schätzung (456 bzw. 2280 Trajektorien) überlappten in allen Intervallen. Code und Daten sind auf GitHub öffentlich. Grenzen laut Autoren: kleine Modelle, mögliche Sättigung, handdesignte History-Features.
AutoRefine: Judge-Prompts aus Outcome-Labels nachkalibrieren
Metas AutoRefine (arXiv:2611.09291) kalibriert deploybare Code-Judges auf Labels, die der Workflow freihaus liefert (Tests bestanden, Diff landed/abandoned). Ein informierter Teacher sieht Judge-Input plus Outcome, begründet behaltene Labels und enthält sich, wenn das Outcome aus der Judge-Sicht unerklärbar ist; die Enthaltungsquote dient zugleich als Monitorsignal für fehlende Judge-Inputs. Die Schleife (maximal fünf Iterationen, balancierte Edits, Validierungssplit) hob einen Rubrik-Judge (Claude Opus 4.8) auf einem Execution-Oracle von π = 0,36 auf 0,60; Schwellenwert-Tuning erreichte bestenfalls 0,42. Ohne Referenzpatch kam die Kalibrierung nur auf π = 0,35: Der Teacher enthielt sich bei 12 von 13 unsichtbaren Fehlschlägen und bei 0 von 72 Passes; zwei menschliche Teams übersahen diese Fehler ebenfalls nahezu vollständig. Bei 25 Prozent injiziertem Labelrauschen senkte die Enthaltung das Rauschen von 24,9 auf 20,4 Prozent (Fisher p = 0,004), ließ aber fehlerhafte Diffs mit Pass-Label mehrheitlich durch - asymmetrisch by design, auf Recall guter Diffs abgestimmt.
Praxisteil: Beim internen Optimierungsagenten stieg π auf 17 unabhängigen Test-Diffs von 0,16 auf 0,51, die Landed-Recall erreichte mit 8/8 das Ziel 0,90 (43-Diff-Slice: +0,31 [0,03; 0,61]). Ergebnisrelevante Ausnahme: Auf 16 Legacy-Diffs der alten Pipeline bleibt der bisherige Judge vorn (π 0,50 vs. -0,02) - Grundlage der Empfehlung, bei jeder Agenten-Änderung nachzukalibrieren. Auf 512 terminalen Diffs enthielt sich der Teacher bei 60 Prozent nach Review verworfener Diffs, 32 Prozent der Entwürfe und 5,5 Prozent gelandeter (p = 10 hoch -5); Reviewer-Kommentare benennen bei behaltenen Verwürfen häufiger im Diff sichtbare Defekte (13/19 vs. 14/38, p = 0,048). Threats to validity: eine Plattform, ein Agent, Judge und Teacher aus derselben Modellfamilie (Self-Preference-Risiko), kleine Stichproben.
Multi-step SWE: 574 Schritte auf dem eigenen Code
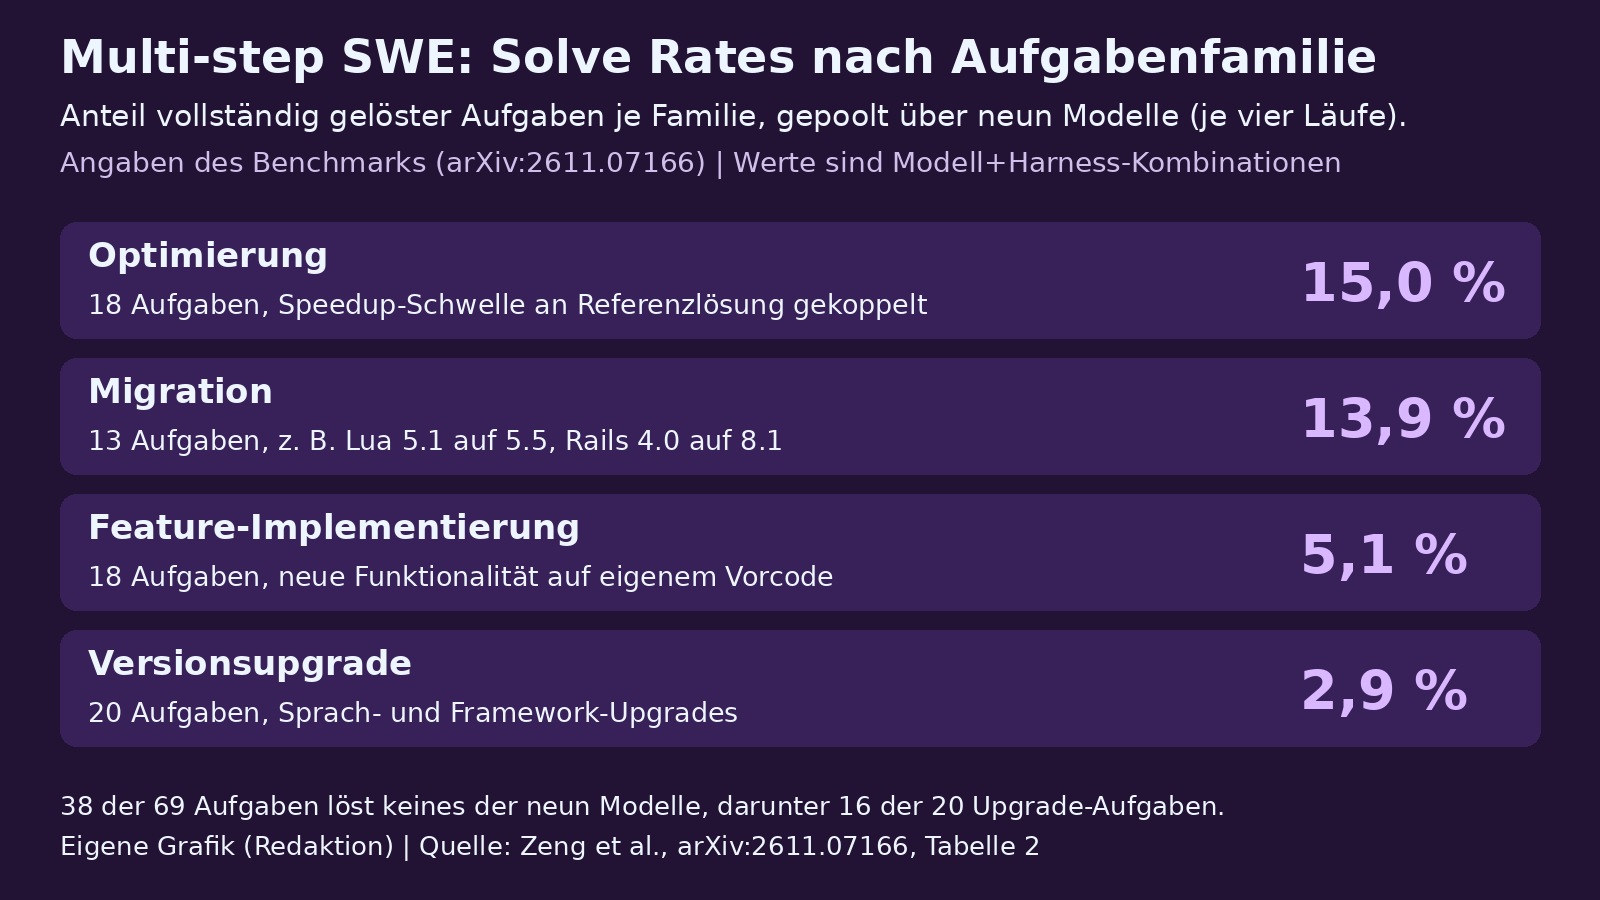
Multi-step SWE (Klavis AI, arXiv:2611.07166) verkettet 69 Aufgaben aus je 5 bis 15 Schritten (574 insgesamt, Median 8, Budget 2 bis 4 Stunden je Schritt) in vier Familien (Optimierung 18, Feature 18, Versionsupgrade 20, Migration 13) und neun Sprachen. Schritt k startet aus dem Workspace, den der Agent in Schritt k-1 hinterlassen hat; jeder Schritt hat eigene Anweisung, Verifizierer und binäre Belohnung; die Aufgabe gilt nur bei Volldurchlauf als gelöst. Anweisung und Verifizierer leiten sich aus derselben Source of Truth ab (offizielle Konformitätssuiten wie Lua-Tests, php-src .phpt, BoGo; Release-Historien wie 15 turso-Versionen; Original-Codebases wie Rails 4.0→8.1). Zwei Expertenrunden (≥5 Jahre Berufserfahrung) prüften jede Aufgabe. Adversarial Hardening dokumentiert sechs erfolgreiche Angriffe auf frühe Verifizierer - darunter Reward-File-Rewrite, gepflanzter JUnitCore, Output-Caching (194-facher Speedup vs. 38-fach Referenz) - samt Gegenmaßnahmen.
Neun Modelle liefen je viermal in Harbor-Harnesses (Claude Code, Codex CLI, mini-swe-agent, Grok Build) mit höchstem Reasoning-Einsatz; die Werte sind Modell-plus-Harness-Kombinationen. Claude Opus 5.5 führt mit 18,5 Prozent Solve Rate [11,6; 25,7], 31,9 Prozent Pass@4 und 56,8 Prozent bestandenen Einzelschritten; Claude Fable 5.1 folgt mit 17,8 Prozent und führt die Optimierungsfamilie mit 45,8 Prozent an. 38 der 69 Aufgaben löst kein Modell, darunter 16 der 20 Upgrade-Aufgaben (Familien-Solve-Rate 2,9 Prozent). Im Aufgabenverlauf sinkt der Anteil fehlerfreier Läufe über alle Modelle von 34,9 Prozent im ersten Fünftel auf 9,0 Prozent im letzten; ein Schritt nach einem bestandenen wird zu 70,2 Prozent bestanden, nach einem gescheiterten zu 14,1 Prozent. Nur 12 Prozent der Fehlschläge liefen bis auf höchstens fünf Minuten an das Zeitlimit heran; in 52 Prozent der gescheiterten Schritte meldete der Agent Fertigstellung ohne benannten Mangel Unter allen Fertigmeldungen ohne benannten Mangel scheiterte der Schritt trotzdem in 57 Prozent der Fälle am Verifizierer. Bestandene Läufe prüften gegen unabhängige Orakel (BoGo-Runner, DWARF-4/5-Vergleich) statt gegen eigene Tests - bei denen eine Fehllesung nur bestätigt wird. Limitationen: C/C++-Lastigkeit (38/69), Memorisation nicht ausschließbar, Optimierungsschwelle = Referenzlösung, nicht bestmöglich.
Quellen
- Knowing When to Intervene: Causal Evaluation of AI Agents, arXiv (Stanford University) (abgerufen 2026-11-09)
- Code und Analysedaten zur Interventions-Studie, GitHub / sawarniayush (abgerufen 2026-11-09)
- AutoRefine: Auto-Calibrating Code Judges from Workflow Outcomes, arXiv (Meta) (abgerufen 2026-11-09)
- Multi-step SWE: Can Coding Agents Keep Building on Their Own Code Over Long Horizons?, arXiv (Klavis AI) (abgerufen 2026-11-09)