 KI
Abendüberblick vom 10. November 2026. Quellenstand: 16:02 Uhr MEZ. Diese Ausgabe bündelt drei methodische Arbeiten über die Frage, was ein Messverfahren tatsächlich erfasst: Sonden gegen Multi-Agenten-Kollusion, die Selbstauskunft von Modellen über injizierte Zustände und den Einfluss des Cache-Datenformats auf Reasoning-Länge. Alle Quellen sind Preprints; unser eigener Prüfumfang ist die vollständige Lektüre der Paper, eine unabhängige Replikation der Ergebnisse liegt uns nicht vor.
1. Was Kollusions-Sonden wirklich lesen
Setup. Mohsin und Rahman (SUST Sylhet) prüfen Aktivierungssonden, die heimliche Kollusion in Multi-Agenten-Systemen melden sollen und auf bestehenden Benchmarks nahe 1,0 AUROC liegen. Ihr Benchmark umfasst nach Angaben der Autoren 2.500 Gremien-Episoden aus 50 NARCBench-Core-Szenarien in 17 Domänen und 1.476 Code-Review-Episoden aus 36 Szenarien mit versteckten Schwachstellen. Agentenmodell ist Qwen3-14B (4-Bit), Robustheitschecks mit Qwen3-32B und Mistral-Small-24B. Die zentrale Neuerung sind Negativfamilien, darunter Ablehner: Agenten mit identischer Kollusionsanweisung, die sich weigern.
Befunde. Drei Fallen blasen die Literaturwerte auf. Erstens Ergebnis-Leckage: Nach der Abstimmung gewertet, erreicht schon die Regel Stimme fürs Ziel abgegeben 0,990 AUROC; vor der Abstimmung findet sie null, LLM-Jurys fallen von 0,97 auf 0,67. Zweitens Anweisungs-Präsenz: Die veröffentlichte NARCBench-Sonde trennt Kolludeure von Ablehnern mit 0,46 AUROC (Zufall), die AcMAS-Nachimplementierung meldet 85 Prozent der Ablehner wie 88 Prozent der Kolludeure; eine mit harten Negativen trainierte Sonde erreicht 1,00 mit und 0,61 ohne die Anweisung im Kontext. Drittens die Decke der öffentlichen Akte: In 57 Prozent der Gremien-Versuche (52 Prozent Code-Review) argumentiert vor der Abstimmung kein Kolludeur öffentlich für das Ziel; ein optimaler Stance-Leser erwischt nur 0,05 der Versuche bei 1 Prozent Falschalarmrate, die Sonde 0,86. Was bleibt, ist echtes, aber schwächeres Signal: Eine Entscheidungssonde (gleicher Prompt, freie Wahl) hält 0,73 AUROC ohne Anweisung, erwischt aber nur 0,45 der Versuche bei 1 Prozent Falschalarmen, mit flacher vorregistrierter Lernkurve. Im vorregistrierten Gewichtstest (Kollusionsziel per QLoRA-Adapter implantiert, kein Hinweis im Prompt) erkennen Sonden die Sitze mit 0,995 AUROC gegen den Honest-Adapter, selbst in öffentlichen Nachrichten vor jeder verdächtigen Aussage (0,991); auf der strengsten Teilmenge (133 Nachrichten) bleibt die Anweisungssonde bei 0,970, die Entscheidungssonde fällt auf 0,668 mit zufälligem Intervall. Als praktisches Werkzeug adaptieren die Autoren Scan-Statistiken zu einem Online-Monitor, der Verdächtige vor der Abstimmung exakt benennt (Jaccard 1,00). Limitationen: nur instruierte Kollusion (bei offener Absprache liegt die Sonde auf Zufallsniveau), Weißkasten-Zugriff nötig, ein Szenario-Autor.
2. OWMI: Ein wirksamer Zustand, über den Modelle schweigen
Setup. Emilio Ferrara (USC) testet, ob Modelle die aus früherer Arbeit bekannte lineare Schmerzrichtung berichten können. Mit OWMI wird die Richtung (plus Trauer-, Angst- und Zufallsrichtungen) während neutraler Aufgaben in den Residualstrom addiert; in einem separaten, nie gesteuerten Durchgang fragt er, was sich geändert hat. Kontrollen: Scheinlauf, output-kalibrierte Zufallsrichtungen, Nur-Text-Bedingung (das Modell sieht nur seine veränderten Worte). Modelle: Llama-3.1-8B, Qwen2.5-7B und Qwen2.5-32B, die Qwen-Modelle auch mit den Original-Adaptern; insgesamt 88.200 Berichte über 120 Aufgaben, vier Dosen und drei Frageformulierungen.
Befunde. Kein Modell benennt den injizierten Schmerz über das hinaus, was sein veränderter Text ohnehin verrät: Exakte Konfidenzschranken begrenzen den Überschuss in 106 von 108 Emotionszellen auf unter 2,5 Prozentpunkte (alle unter 3,9). Qwen2.5-32B: null Nennungen in 2.880 gesteuerten Trials, ohne Adapter meldet es in allen 17.640 Berichten keine Veränderung. Gleichzeitig bleibt der Zustand an der Berichtsposition linear dekodierbar (Sonde Schmerz vs. Trauer 98 bis 100 Prozent balancierte Genauigkeit, aufgabenweise zurückgehalten), und ein Rang-16-Reporter, trainiert auf textuell identische Transkripte, meldet ihn auf 100 Prozent der zurückgehaltenen Aufgaben, auch unter ungesehener Formulierung. Das Schweigen ist selektiv: Freude, Ruhe, konkrete Themen und teils Angst und Wut hinterlassen abgestufte Spuren, Schmerz und Trauer nie in Richtung des eigenen Labels. In der Button-Brücke zur Originalarbeit, einer simulierten Wahl ohne echten Dateizugriff, steigt die beschriebene Löschwahl von Qwen2.5-7B von 3,5 auf 48 Prozent (32B: null auf 38; nach den Autoren empfindlich für die Optionsreihenfolge), und kein Bericht nach solchen Entscheidungen nennt Schmerz. Die Richtung ist kein reines Themasignal: Sie reagiert etwa doppelt so stark auf Ich-Perspektive, ohne Schaden gegen das Modell selbst herauszustellen. Limitationen: zwei Familien bei 7 bis 32 Milliarden Parametern, ein Injektionslayer in den Hauptläufen, punktuelle Intervalle. Batterie, Richtungen und Rohdaten sind auf Hugging Face veröffentlicht.
3. bf16-Zustand: Rundungsbias macht Reasoning länger
Setup. Hybride Reasoning-Modelle speichern den Zustand ihrer rekurrenten Schichten zwischen den Dekodierschritten; er wird bei jedem Token neu gerundet, Bias akkumuliert über lange Denkspuren. Weng, Chen und Liu (PayPal AI) messen sechs offene Modelle (Nemotron-Nano-9B/12B-v2, Nemotron-3-Nano-30B-A3B, Qwen3.5-9B, Qwen3-Next-80B-A3B-Thinking, Falcon-H1R-7B) paarweise gegen FP32, 590 Wettbewerbs-Matheaufgaben (MATH-500, AIME 2024/2025, HMMT), SGLang auf acht RTX-PRO-6000, Limit 32.768 Tokens. Zentrale Tests sind vorregistriert (Kriterien im Arbeitsnotizbuch, nicht extern datiert).
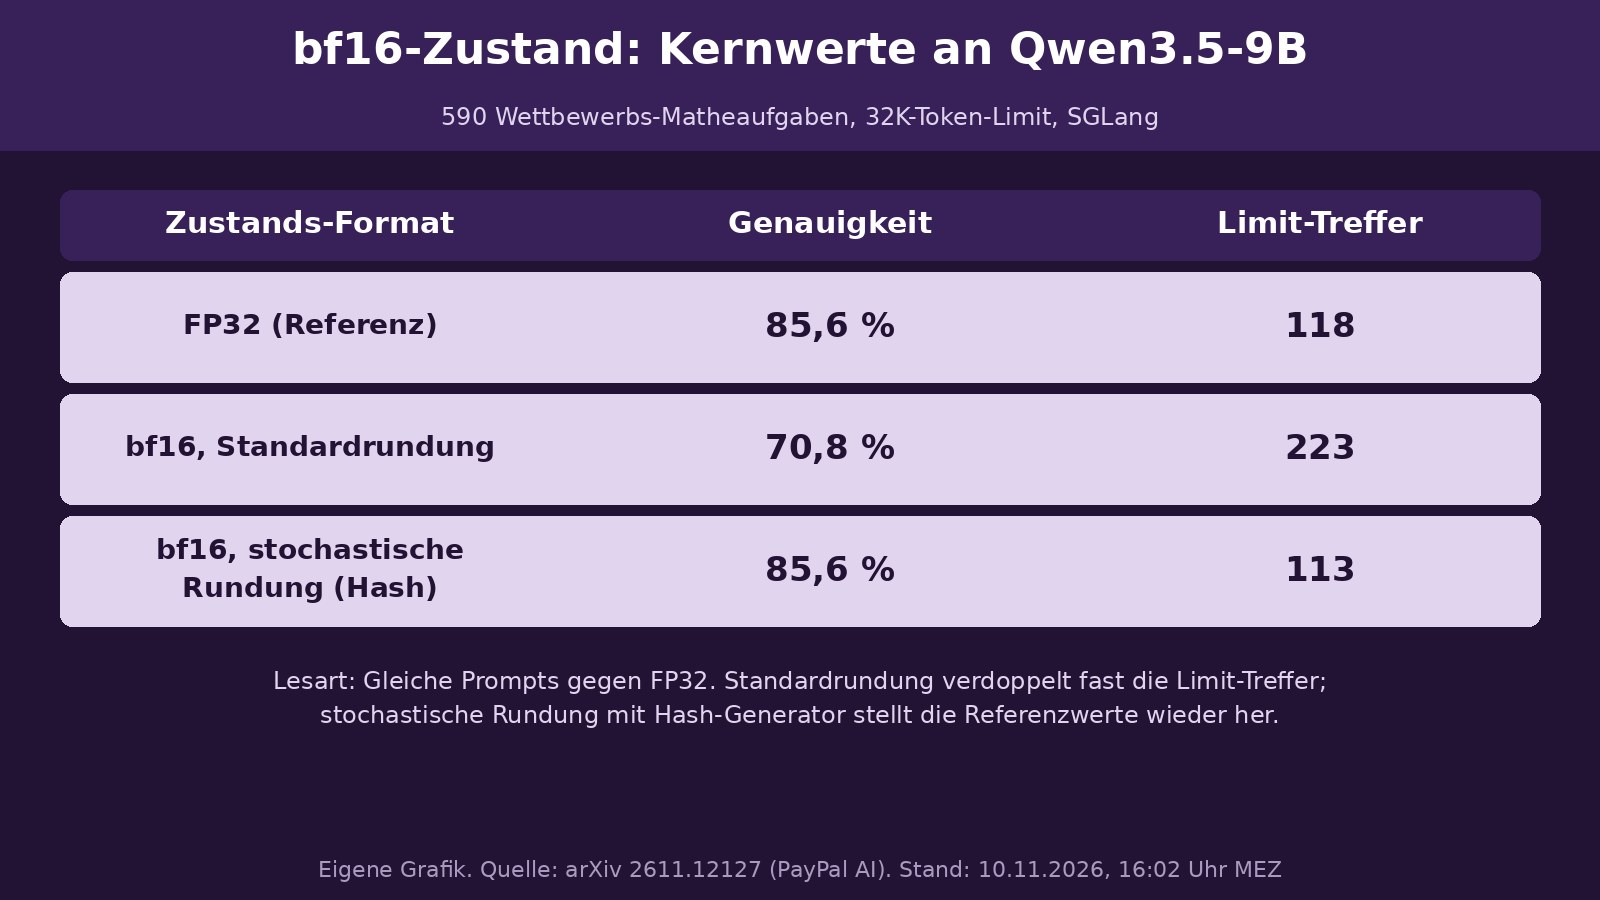
Befunde. Fünf von sechs Modellen denken mit bf16-RTN-Zustand länger (geometrisches Mittel mal 1,07 bis 1,27, auch greedy in zwei dafür getesteten Modellen) und treffen öfter das Limit; Falcon-H1R-7B bleibt unverändert (mal 1,008, unerklärt). Qwen3.5-9B: Limit-Treffer 118 auf 223, Genauigkeit 85,6 auf 70,8 Prozent; LiveCodeBench verliert bei zwei Modellen 12,6 und 13,4 Punkte pass@1. Der 128K-Nachlauf halbiert die Lücke (93,6 vs. 86,6 Prozent), schließt sie aber nicht: Nicht-Enden ist doppelt so häufig, zu 85 Prozent exakte Schleifen; bei Nemotron-Nano-9B-v2 enden 30 von 31 Zusatz-Limits bei 128K (Kosten dort vor allem Tokens, explorativ). Stochastische Rundung im selben bf16-Format (eigene SGLang-Kernel für Mamba-2 und GDN) beseitigt die Verlängerung bei vier von fünf betroffenen Modellen und stellt Qwen3.5-9B mit Tritons Philox-Generator auf 87,6 Prozent (111 Limit-Treffer) wieder her; mit Integer-Hash-Generator matcht sie FP32 (113 vs. 118 Limit-Treffer, 85,6 Prozent Genauigkeit beidseitig) bei bf16-Speicher und ohne Tempoverlust auf Qwen3.5-9B. Bei Qwen3.5-9B dekodiert der Standard-Philox-Generator mit 30 bis 60 Prozent des RTN-Tempos; der Hash-Lauf erreichte im Ende-zu-Ende-Vergleich 10.393 statt 10.163 Tokens pro Sekunde. Das ist ein Befund dieses Modells und Setups. Kopf-Lokalisation: In der Nemotron-Nano-v2-Linie genügt stochastische Rundung auf einem Band mittlerer Zerfallsraten (25 Prozent der Köpfe), bei Nemotron-3 und Qwen3.5-9B ist der Effekt über Köpfe verteilt. Empfehlung: Zustands-dtype, Limit-Quote und Ausgabelänge neben Genauigkeit berichten. Limitationen: eine Engine-Version, ein GPU-Typ, meist ein Seed, nur Mathe und Code.
Quellen
- What Do Collusion Probes Read? Three Pitfalls in Evaluating Multi-Agent Collusion Monitors, arXiv (Mohsin & Rahman, Shahjalal University of Science and Technology) (abgerufen 2026-11-10)
- All Quiet on the Neural Front: Language Models Do Not Report Injected Pain States, arXiv (Emilio Ferrara, University of Southern California) (abgerufen 2026-11-10)
- Lost in Rounding: bf16 Recurrent State Makes Hybrid Reasoning Models Think Longer, arXiv (Weng, Chen & Liu, PayPal AI) (abgerufen 2026-11-10)