 KI
Mittagsüberblick vom 8. November 2026. Quellenstand: 09:50 Uhr MEZ. Shizuku-Duplex verbindet fortlaufende Sprachverarbeitung mit einem asynchronen Hintergrundmodell. Dazu zwei neue Themen für diesen Überblick aus den vergangenen Tagen: Planets sprachgesteuerte Satellitensuche und Kinference als Routing-Schicht für vLLM. Deren aktueller README-Stand deckt nicht alle Launchversprechen.
Shizuku-Duplex: 80-ms-Ticks sind keine Antwortlatenz
Der Originalbeitrag von Shizuku AI vom 8. November beschreibt einen japanischen Full-Duplex-Transformer, der während der eigenen Sprachausgabe weiter zuhört. Pro 80-ms-Tick verarbeitet er Audiofeatures und gibt Text, Audiotokens und Aktionen aus. Eine Interaktionskomponente übernimmt den laufenden Dialog; ein separates Hintergrundmodell bearbeitet per DELEGATE-Token übergebene Aufgaben asynchron, einschließlich Websuche. Laut Team ermöglichen TensorRT- und Triton-Optimierungen die Verarbeitung innerhalb dieses Zeitrasters.
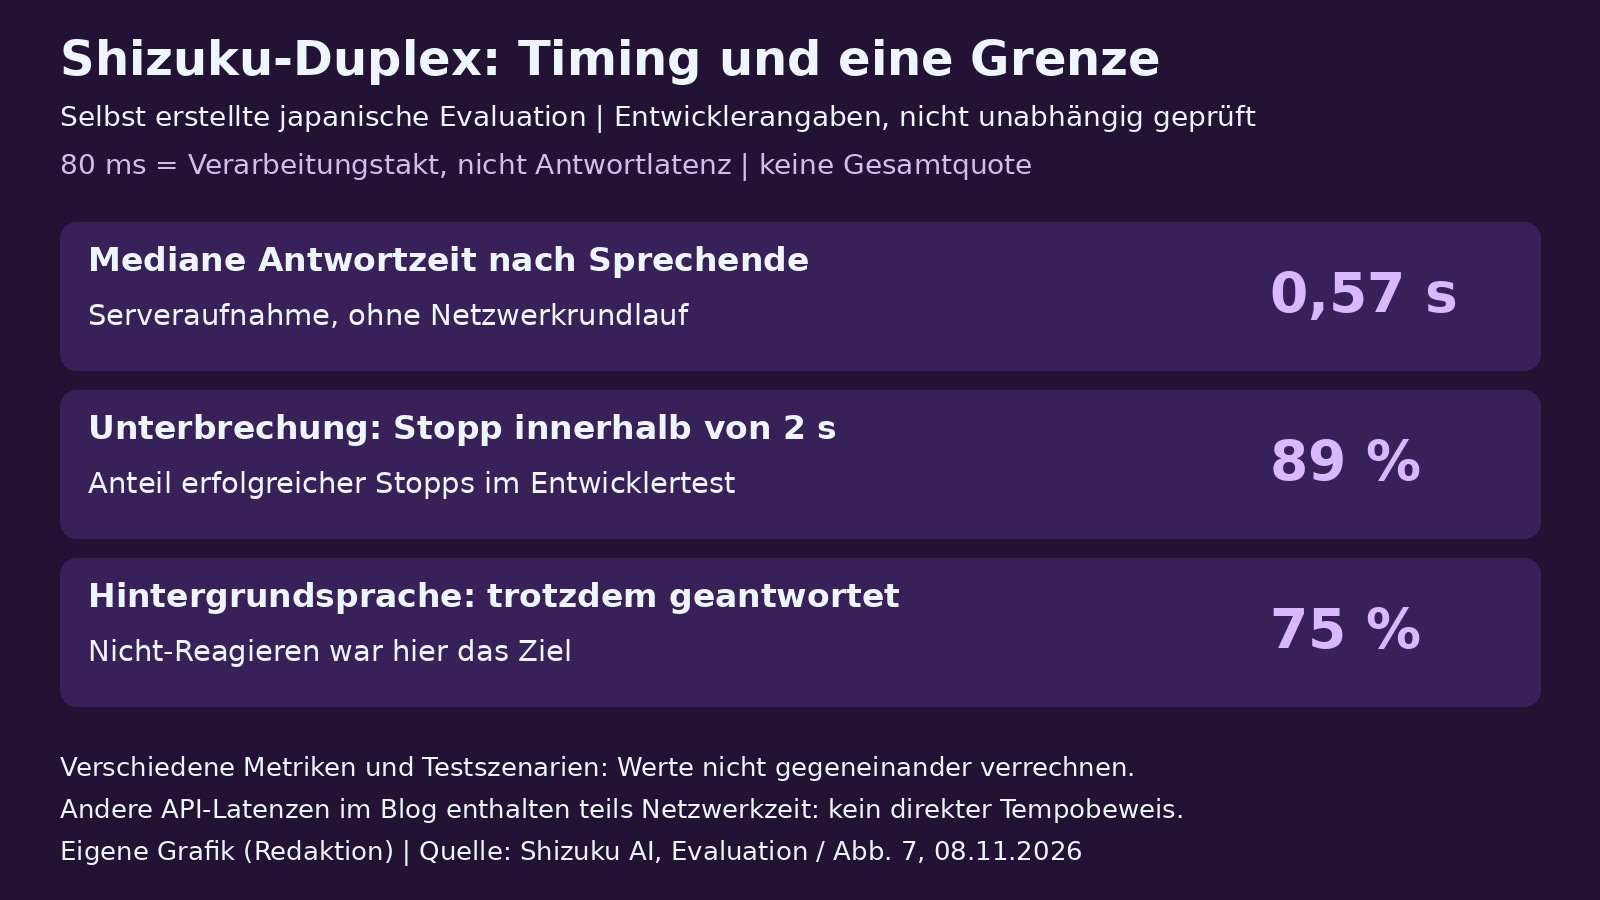
Der Anbieter evaluiert auf selbst erstellten japanischen Szenarien nach Mustern von Full-Duplex-Bench und M3-DuplexBench; Inhalte wurden mit Claude Opus 5.5 bewertet. Gemeldet werden 0,57 Sekunden mediane Zeit ab Sprechende und 89 Prozent Stopps innerhalb von zwei Sekunden bei Unterbrechungen. Die Latenz basiert auf Serveraufnahmen ohne Netzwerkrundlauf. Die gegenübergestellten GPT-Realtime-/Gemini-Live-Werte enthalten dagegen Netzwerkzeit, weshalb daraus kein gleichartig gemessener Geschwindigkeitsvorsprung folgt. Ein Gegenbefund: Bei Hintergrundsprache antwortete das Modell in 75 Prozent der Fälle, obwohl Nicht-Reagieren das Ziel war. Alle Angaben stammen vom Entwickler. Der Beitrag ist kein Nachweis eines offenen Gewichte-Releases; zusätzliche Sprachen und visuelle Eingaben stehen im Ausblick.
Planet AI: Vektorsuche über monatliche Bildmosaike
Planet erläutert im Launchbeitrag vom 5. November eine Chat-/Kartenoberfläche für mehr als zehn Jahre Satellitenbildarchiv. Ein LLM interpretiert Suchbeschreibungen und fragt eine Vektorkarte ab, die aus der KI-Interpretation visueller Merkmale monatlicher Mosaike entsteht. Nutzer sollen Fundorte über Zeit vergleichen, Zeitraffer erzeugen sowie eigene Bilder und CSV-Dateien einbringen können. Für weitergehende Untersuchungen beschreibt Planet Agenten und geplante Berichte.
Entscheidend ist die Trennung von Entdeckung und Befund: Die Suche priorisiert Orte für die weitere Analyse. Sichtbare Originalbilder erleichtern die Überprüfung, garantieren aber keine richtige Deutung durch das Modell. Der Launchtext nennt Anwendungsbeispiele aus Naturschutz und Umweltkontrolle, jedoch keinen unabhängigen Treffer- oder Fehlerbenchmark. Aus einem über zehnjährigen Archiv und täglichen Satellitenaufnahmen folgt zudem keine Echtzeitauflösung jedes Suchergebnisses; die beschriebene Vektorsuche basiert auf Monatsmosaiken. Die App wurde für diesen Überblick nicht selbst funktional getestet.
Kinference: Funktionskatalog und README widersprechen sich
Buoyant meldete Kinference am 4. November als allgemein verfügbare Inferenz-Steuerungsschicht für Kubernetes und vLLM. Der begleitende vLLM-Blog und die Produktseite stellen richtliniengesteuertes Routing, KV-Cache-bewussten Lastausgleich, Tokenlimits, semantische Klassifikation und OpenAI-/Anthropic-kompatiblen Verkehr dar. Der Nutzen des Cache-Routings liegt darin, bereits berechnete Prompt-Präfixe auf dem passenden Worker wiederzuverwenden statt sie erneut zu verarbeiten.
Das öffentliche Repository wurde unter Kinference-AI/kinference geöffnet. Die aktuelle README beschreibt eine gRPC-Schnittstelle, die für eine Anfrage Endpunkt und gegebenenfalls angepassten Body zurückgibt, vLLM-Cache-Ereignisse und Engine-Metriken auswertet und mit einem Proxy zusammenarbeitet. Unter Known limitations nennt sie zugleich Alpha-Status ohne längere Produktionserfahrung. Noch fehlend seien /v1/messages, Rate Limiting, semantische Klassifikatoren und mehrere Replikate. Diese Angaben stehen dem breiteren Funktionskatalog entgegen. Ohne Versions- und Auslieferungsabgleich sind daher weder vollständige API-Kompatibilität noch die beworbenen Richtlinienfunktionen als verfügbar bestätigt; ein eigener Laufzeit- oder Lasttest liegt nicht vor.
Quellen
- Shizuku-Duplex: Japanese Full-Duplex Model for Natural Conversation, Shizuku AI (abgerufen 2026-11-08)
- Introducing the Planet AI App: Search. Explore. Act., Planet (abgerufen 2026-11-08)
- Buoyant Announces Kinference: An Open Source Inference Serving Platform for Kubernetes, Buoyant (abgerufen 2026-11-08)
- Introducing Kinference: An Open Source Inference Control Plane for vLLM and Kubernetes, vLLM Blog / Buoyant (abgerufen 2026-11-08)
- Kinference-AI/kinference: README und Known limitations, GitHub / Kinference-AI (abgerufen 2026-11-08)
- Kinference: Produktbeschreibung und Policies, Kinference (abgerufen 2026-11-08)