 KI
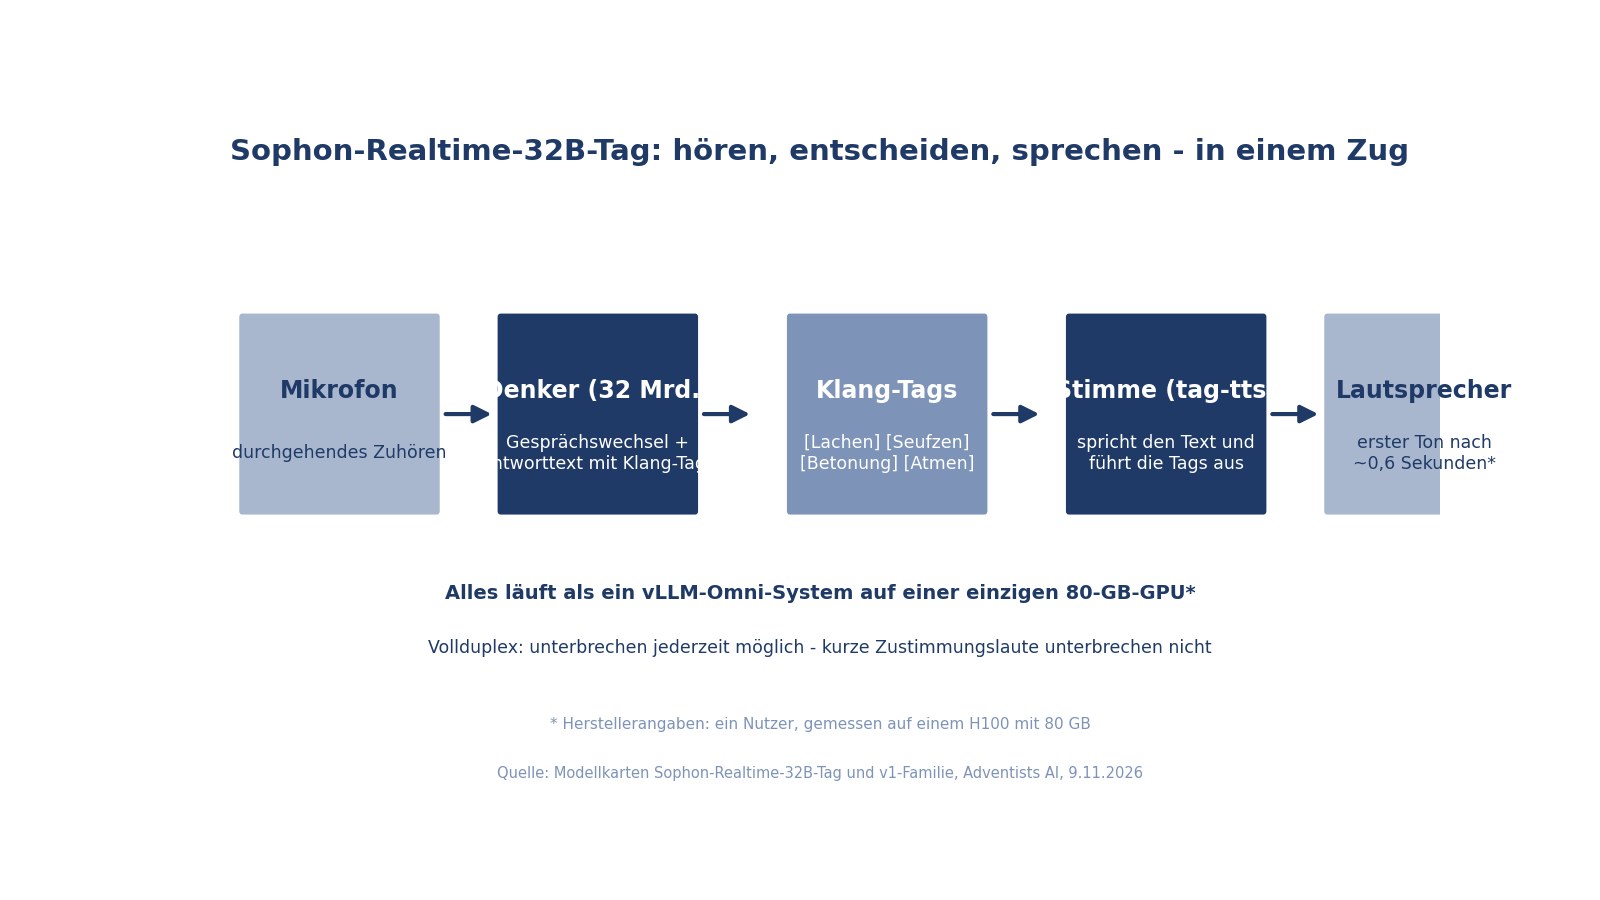
Sprachassistenten, die einen erst nach einer Pause antworten und stur weiterreden, wenn man dazwischengeht, wirken schnell gekünstelt. Sophon-Realtime-32B-Tag von Adventists AI geht den anderen Weg: Das Modell hört durchgehend zu, erkennt nach Anbieterangaben auch, wie etwas gesagt wird - Zögern, Betonung, Sarkasmus, Lachen - und antwortet mit einer Stimme, die ihrerseits lachen oder seufzen kann. Code und Gewichte stehen unter Apache 2.0, das Gespräch läuft laut Anbieter auf einer einzigen 80-GB-GPU [1][2]. Das Repositorium wurde am 29. Oktober 2026 angelegt und zuletzt am 9. November 2026 aktualisiert (Plattform-API) [4].
Eckdaten
Aufbau: ein Denker, eine Stimme
Der Kern ist DuplexJev-32B-Para v1.5, ein 32-Milliarden-Parameter-Modell in FP8 mit Vision-Komponente. Es übernimmt drei Aufgaben zugleich: zuhören, entscheiden, wann es an der Reihe ist, und die Antwort schreiben. In den Antworttext streut es Klang-Tags ein - etwa für Lachen, Atmen, Seufzen, Räuspern oder die Betonung eines Wortes. Diese Tags werden nicht vorgelesen, sondern an das zweite Modul übergeben: tag-tts, ein Stimmmodell auf Basis von Fun-CosyVoice3-0.5B mit destilliertem Flow in vier Schritten und HiFT-Vocoder. Es spricht den Text, während er noch geschrieben wird, und führt die Tags als Klang aus [1].
Betrieb und Schnittstellen
Der Anbieter nennt als Voraussetzung eine GPU mit 80 GB (H100, H800 oder A100 80G) mit rund 65 GB Belegung pro Instanz; der Gewichte-Download umfasst etwa 42 GB. Bereitgestellt wird alles über vLLM-Omni mit einem Installations- und einem Startskript - oder per pip-Paket. Zwei Schnittstellen stehen bereit: ein WebSocket-Endpunkt für das Vollduplex-Gespräch (Gesprächswechsel, Unterbrechen, Zwischenlaute) und eine Chat-Completions-API, die Audio entgegennimmt und Text plus Audiostream zurückgibt. Sechs Referenzstimmen sind enthalten; die Sprachen sind Englisch und Chinesisch [1][3].
Verfügbarkeit und Lizenz
Denker, Stimme und die sechs Stimmen-Referenzen stehen unter Apache 2.0, kommerzielle Nutzung ist erlaubt. Ein Live-Modus spricht das GPT-Live-Protokoll von OpenAI, sodass bestehende Clients per Adresswechsel angebunden werden können; dabei bleibt die Sophon-Stimme erhalten, während Rechercheaufgaben an ein eigenes Backend gehen. Feintuning für Persona, Ton und Fachwissen ist per LoRA über ms-swift vorgesehen - Gehör, Stimme und Gesprächssteuerung bleiben dabei unverändert. Ausprobieren lässt sich das Modell ohne eigene Hardware in einem ModelScope-Studio [1][2][3].
Was Vollduplex hier bedeutet
Vollduplex heißt: Das Modell hört zu, während es selbst spricht, und umgekehrt. Es beginnt die Antwort zu entwerfen, während man noch redet, setzt ein, sobald man aufhört, stoppt, wenn man dazwischengeht, und lässt sich von kurzen Zustimmungslauten wie einem Mhm nicht aus dem Konzept bringen. Vom Ende des eigenen Satzes bis zum ersten Ton des Modells misst der Anbieter rund 0,7 Sekunden [1].
Drei Builds, ein Gehirn
Die Familie umfasst drei Varianten mit identischem 32-Milliarden-Denker; sie unterscheiden sich nur in der Stimme. Tag ist die empfohlene, ausdrucksstärkste Variante (NVV-SuperBench 0,80 auf Englisch, 0,86 auf Chinesisch). Flash nutzt ein leichteres Stimmmodell und ist auf Tempo und Auslastung getrimmt: 0,31 Sekunden bis zum ersten Ton und bis zu 40 gleichzeitige Nutzer pro GPU, bei schwächerem Klangausdruck (0,63/0,77). E2E ist eine Forschungsvorschau ohne separates Stimmmodell, braucht zwei GPUs und kommt auf vier bis fünf Nutzer. Alle Werte sind Herstellerangaben; die Schnittstellen sind identisch, ein Wechsel ist später möglich [1][2].
Messwerte und Latenzen
Bei den Verständnistests meldet der Anbieter 82,8 auf VoiceBench und 81,8 Prozent auf Big Bench Audio - nach eigener Darstellung die besten Werte unter den offenen Vollduplex-Modellen und auf VoiceBench auf Augenhöhe mit GPT-4o-mini-Audio. Beim paralinguistischen Verständnis (LISTEN, StressTest, MSPB) erreicht Sophon 48,6 Punkte; die vom Anbieter genannten Vergleichswerte sind Gemini 3.8 Flash mit 46,9 und Qwen3-Omni mit 44,6. Beim Werkzeugaufruf im Gespräch (Full-Duplex-Bench v3, Pass@1) meldet der Anbieter 48 Prozent vor Grok mit 43 Prozent, bei 100 Prozent Antwortrate. Alle Vergleiche stammen aus den Tabellen des Anbieters [1][2].
Daten als Tabelle
| Erster Ton (Median) | |
|---|---|
| 1 Nutzer | 0,67 |
| 8 Nutzer | 0,61 |
| 16 Nutzer (Empfehlung) | 0,75 |
| 24 Nutzer | 1,36 |
Herstellerangaben, gemessen auf einem H100 mit 80 GB; die Nutzer treffen innerhalb von zehn Sekunden ein [1]. Ab 24 Nutzern beginnt laut Anbieter das Warteschlangen-Verhalten - er empfiehlt bis zu 16 gleichzeitige Nutzer pro GPU. Von uns nicht nachgemessen.
Die Latenztabelle des Anbieters zeigt auch die oberen Werte: Bei 16 Nutzern liegt das Maximum bei 1,07 Sekunden und der mediane Stotter-Anteil bei 0,06 Sekunden; bei 24 Nutzern steigt der Median auf 1,36 Sekunden und Warteschlangen setzen ein. Der Prozessor ist laut Anbieter nicht der Engpass (etwa 1,5 Kerne pro Instanz bei 16 Nutzern); mit einer Instanz pro GPU hinter einem Lastverteiler soll die Kapazität ungefähr linear wachsen [1].
Klang-Tags: was die Stimme wirklich umsetzt
Bemerkenswert ist, wie offen der Anbieter die Schwachstelle benennt. In einem eigenen Test (96 Sätze, zweimal durch die komplette bereitgestellte Kette, automatischer Detektor) kamen die geschriebenen Tags nicht immer hörbar an: Beim Seufzen erkannte der Detektor nur 25 Prozent der Ereignisse (Referenz-Renderer mit demselben Stimmmodell: 42 Prozent), beim Lachen 42 Prozent (Referenz: 50), bei Atmen 50 und beim Husten 33 Prozent (jeweils gleichauf). Wegen der kleinen Stichprobe entspricht ein Satz schon etwa zehn Prozentpunkten. Der Anbieter nennt Seufzen und Betonung ausdrücklich noch schwach [1].
Weitere benannte Grenzen: Chinesisch klingt mit dem destillierten Flow etwas weniger klar als Englisch, und ein Lachen wird von der Erkennung gelegentlich als Text transkribiert. Antworten über etwa einer Minute gesprochener Länge übersteigen das Trainingsmaterial der Stimme [1].
Einordnung und Prüfgrenzen
Sämtliche Zahlen sind Herstellerangaben mit offengelegten Messbedingungen; wir haben das System nicht selbst betrieben - dafür fehlt uns die 80-GB-GPU. Da Gewichte, Code und Deployment-Skripte offen liegen, ist eine unabhängige Nachmessung grundsätzlich möglich. Die Vergleiche mit GPT-4o-mini-Audio, Grok, Gemini 3.8 Flash und Qwen3-Omni entstammen den Tabellen des Anbieters; die E2E-Variante ist noch nicht veröffentlicht. Ob es Fremdmessungen gibt, können wir nicht ausschließen [1][2].
Methode
Analyse auf Basis der vollständig gelesenen Modellkarte von Sophon-Realtime-32B-Tag (inklusive Latenztabelle und Klang-Tag-Test), der Familienseite Sophon-Realtime v1 mit den Benchmark-Methoden, des GitHub-Repositorys und der Repositorium-Metadaten der Plattform-API (jeweils abgerufen am 9.11.2026). Sämtliche Messwerte sind Herstellerangaben. Keine eigenen Tests.
Grenzen
Keine eigenen Tests; der Betrieb erfordert eine 80-GB-GPU, die uns nicht zur Verfügung stand. Alle Benchmark-, Latenz- und Auslastungswerte stammen vom Anbieter, ebenso die Vergleiche mit anderen Modellen. Der Klang-Tag-Test des Anbieters beruht auf einer kleinen Stichprobe (96 Sätze, zwei Durchläufe) mit etwa zehn Prozentpunkten Unsicherheit pro Satz. Ob es unabhängige Fremdmessungen gibt, können wir nicht ausschließen. Die E2E-Variante ist eine angekündigte Vorschau und noch nicht verfügbar.
Quellen
- Sophon-Realtime-32B-Tag - Modellkarte (inklusive Latenzmessungen und Grenzen), Adventists AI (Hugging Face) (abgerufen 2026-11-09) ↩1 ↩2 ↩3 ↩4 ↩5 ↩6
- Sophon-Realtime v1 - Familienseite mit Benchmark-Methoden, Adventists AI (Hugging Face) (abgerufen 2026-11-09) ↩1 ↩2 ↩3 ↩4 ↩5 ↩6
- sophon-realtime - GitHub-Repository (Ein-Befehl-Deployment, Live-Modus, Feintuning), Adventists AI (GitHub) (abgerufen 2026-11-09) ↩1 ↩2
- Repositorium-Metadaten (Anlagedatum, letzte Aktualisierung, Downloads), Hugging-Face-API (abgerufen 2026-11-09) ↩